第 14 章 线性模型

CHAPTER STATUS编写进度70%查看全书进度

14.1 一般线性模型

Definition 14.1. 设\((\Omega,\mathscr{F},P)\)为概率空间,\(X\in\mathbb{R}^{n\times p}\)为给定的非随机矩阵,参数空间\(\Theta=\mathbb{R}^p\times(0,+\infty)\)。对于参数\((\beta,\sigma^2)\in\Theta\),若随机向量\(Y:\Omega\to\mathbb{R}^n\)满足:

\[\begin{equation*} \begin{cases} Y=X\beta+\varepsilon \\ \operatorname{E}(\varepsilon)=\mathbf{0} \\ \operatorname{Cov}(\varepsilon)=\sigma^2I_n \end{cases} \end{equation*}\]

其中\(\varepsilon:\Omega\to\mathbb{R}^n\)为随机误差向量,则称上述模型为线性模型(linear model)。称\(X\)为设计矩阵(design matrix)。对固定的\(\omega\in\Omega\),将随机向量\(Y\)的一次观测实现记为\(y\coloneq Y(\omega)\in\mathbb{R}^n\),称\(y\)为观测向量(observation vector);此后\(y\)表示给定的非随机向量。

在实际问题中,设计矩阵\(X\)和观测向量\(y\)是已知的,而参数向量\(\beta\)是未知的。线性模型认为\(Y\)的均值具有线性结构:

\[\begin{equation*} \operatorname{E}(Y)=X\beta \end{equation*}\]

因而我们希望根据观测数据\(y\)寻找一个参数向量,使得相应的拟合值\(X\beta\)能够尽可能接近\(y\)。

由于随机误差的存在,观测向量\(y\)一般并不恰好属于\(X\)的列空间\(\mathcal{M}(X)\),因此方程\(X\beta=y\)通常没有解。为此,我们不再要求拟合值\(X\beta\)与观测向量\(y\)完全相等,而是要求二者之间的差值\(y-X\beta\)尽可能接近\(\mathbf{0}\)。最常用的度量方式是标准范数的平方,由此得到最小二乘法。

Definition 14.2. 对于给定的设计矩阵\(X\in\mathbb{R}^{n\times p}\)和观测向量\(y\in\mathbb{R}^n\),定义:

\[\begin{equation*} Q(b)=||y-Xb||^2=\sum_{i=1}^n\left(y_i-x_i^{\top}b\right)^2,\; b\in\mathbb{R}^p \end{equation*}\]

其中\(x_i^{\top}\)为\(X\)的第\(i\)行。称优化问题:

\[\begin{equation*} \min_{b\in\mathbb{R}^p}Q(b) \end{equation*}\]

为最小二乘问题,称其任意一个最小值点\(\hat{\beta}\)为\(\beta\)的最小二乘估计(least squares estimate, LSE)。

Definition 14.3. 称方程\(X^{\top}X\beta=X^{\top}y\)为正则方程(normal equation)。

Theorem 14.1. 对于定义 14.1,\(\hat{\beta}=(X^{\top}X)^-X^{\top}y\)是\(\beta\)的最小二乘估计,其中\((X^{\top}X)^-\)是\(X^{\top}X\)的任意一个广义逆。

证明. 注意到:

\[\begin{gather*} \begin{aligned} Q(\beta)&=||y-X\beta||^2=(y-X\beta)^{\top}(y-X\beta) \\ &=y^{\top}y-y^{\top}X\beta-\beta^{\top}X^{\top}y+\beta^{\top}X^{\top}X\beta \\ &=y^{\top}y-2y^{\top}X\beta+\beta^{\top}X^{\top}X\beta \end{aligned}\\ \frac{\partial y^{\top}X\beta}{\partial\beta}=X^{\top}y,\quad \frac{\partial \beta^{\top}X^{\top}X\beta}{\partial\beta}=2X^{\top}X\beta \\ \frac{\partial Q(\beta)}{\partial\beta}=-2X^{\top}y+2X^{\top}X\beta=0 \\ X^{\top}X\beta=X^{\top}y \end{gather*}\]

由定理 2.2和定理 2.4(1)可知方程\(X^{\top}X\beta=X^{\top}y\)是相容的,根据定理 2.11可知其通解为:

\[\begin{equation*} \hat{\beta}=(X^{\top}X)^-X^{\top}y \end{equation*}\]

其中\((X^{\top}X)^-\)是\(X^{\top}X\)的任意一个广义逆矩阵。

对任意的\(\beta\),有:

\[\begin{align*} Q(\beta)&=||y-X\beta||^2=||y-X\hat{\beta}+X\hat{\beta}-X\beta||^2=||y-X\hat{\beta}+X(\hat{\beta}-\beta)||^2 \\ &=||y-X\hat{\beta}||^2+||X(\hat{\beta}-\beta)||^2+2(y-X\hat{\beta})^{\top}X(\hat{\beta}-\beta) \end{align*}\]

注意到正则方程即为:

\[\begin{equation*} X^{\top}(y-X\beta)=\mathbf{0} \end{equation*}\]

于是由性质 2.1.2(4)可得:

\[\begin{equation*} 2(y-X\hat{\beta})^{\top}X(\hat{\beta}-\beta)=2[X^{\top}(y-X\hat{\beta})]^{\top}(\hat{\beta}-\beta)=0 \end{equation*}\]

所以:

\[\begin{equation*} Q(\beta)=||y-X\hat{\beta}||^2+||X(\hat{\beta}-\beta)||^2 \end{equation*}\]

当\(\beta=\hat{\beta}\)时上式最小,所以\(\hat{\beta}\)是一个最小二乘解。 ◻

Definition 14.4. 固定\(X^{\top}X\)的一个广义逆\((X^{\top}X)^-\),定义最小二乘估计映射:

\[\begin{equation*} \hat{\beta}:\mathbb{R}^n\to\mathbb{R}^p,\quad \hat{\beta}(z)\coloneq(X^{\top}X)^-X^{\top}z \end{equation*}\]

则\(\hat{\beta}(Y):\Omega\to\mathbb{R}^p\)是由随机向量\(Y\)得到的最小二乘估计量,\(\hat{\beta}(y)\)是其在观测向量\(y\)处的观测值。下文仅讨论给定观测向量\(y\)的最小二乘问题时,将\(\hat{\beta}(y)\)简记为\(\hat{\beta}\)。

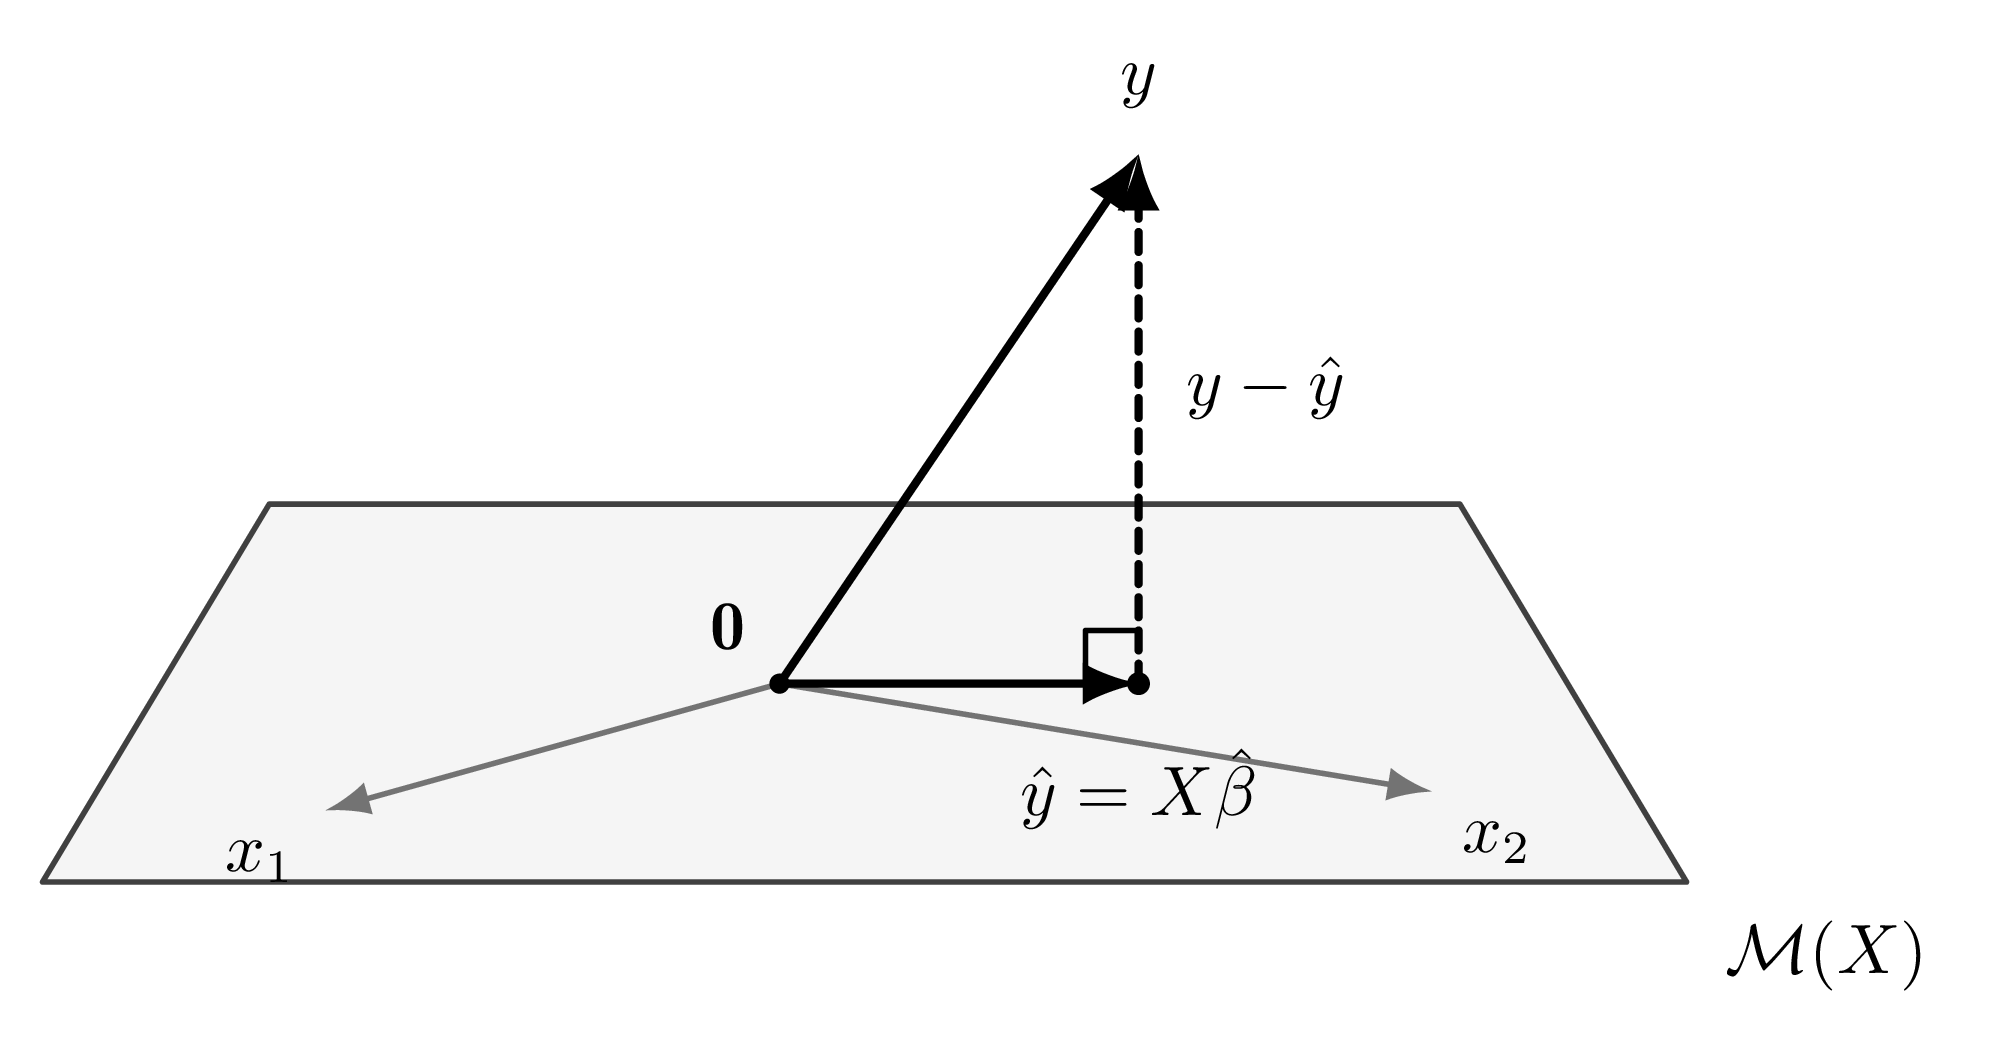
Derivation 14.1. 由于对任意\(b\in\mathbb{R}^p\),向量\(Xb\)都属于\(X\)的列空间\(\mathcal{M}(X)\),故所有可能的拟合值为集合:

\[\begin{equation*} \{Xb:b\in\mathbb{R}^p\}=\mathcal{M}(X) \end{equation*}\]

因此,最小二乘问题等价于在子空间\(\mathcal{M}(X)\)(性质 1.3.1(6))中寻找与\(y\)距离最近的向量,即:

\[\begin{equation*} \min_{z\in\mathcal{M}(X)}||y-z||^2 \end{equation*}\]

若\(\hat{\beta}\)是最小二乘解,并记\(\hat{y}=X\hat{\beta}\),则\(\hat{y}\in\mathcal{M}(X)\)且满足:

\[\begin{equation*} ||y-\hat{y}||=\min_{z\in\mathcal{M}(X)}||y-z|| \end{equation*}\]

由正则方程:

\[\begin{equation*} X^{\top}X\hat{\beta}=X^{\top}y \end{equation*}\]

可得:

\[\begin{equation*} X^{\top}(y-X\hat{\beta})=\mathbf{0} \end{equation*}\]

这表明\(y-\hat{y}\)与\(X\)的每一列都正交,从而与整个子空间\(\mathcal{M}(X)\)正交。故\(\hat{y}=X\hat{\beta}\)正是\(y\)在\(\mathcal{M}(X)\)上的正交投影。

TikZ 数学图示
图 14.1 ŷ = Xβ̂是y在ℳ(X)上的正交投影

note 14.1. 接下来我们将涉及到非常多的公式,初学会觉得非常难记,但如果从投影的角度去理解的话,很多公式都是直观上非常显然的,也就更好记忆了。

14.1.1 参数估计

14.1.1.1 回归系数

Definition 14.5. 设非随机向量\(c\in\mathbb{R}^{p}\)。若存在非随机向量\(\alpha\in\mathbb{R}^{n}\)使得\(\operatorname{E}(\alpha^{\top}Y)=c^{\top}\beta\)对任意的\(\beta\in\mathbb{R}^{p}\)成立,则称\(c^{\top}\beta\)为可估函数(estimable function)。

note 14.2. 由定理 14.1可知\(\beta\)的最小二乘估计一般并不唯一,因此不能直接讨论\(\beta\)本身的估计。由于线性模型通过\(\operatorname{E}(Y)=X\beta\)刻画参数与观测变量之间的线性关系,我们转而关注\(\beta\)的线性函数\(c^{\top}\beta\)。实际能够观测到的是随机向量\(Y\)的一次实现\(y\),因此自然要考察是否存在\(\alpha\in\mathbb{R}^{n}\)使得\(\alpha^{\top}Y\)是\(c^{\top}\beta\)的线性无偏估计量。

Property 14.1.1. 对于定义 14.1,设\(c^{\top}\beta\)和\(d^{\top}\beta\)是可估函数,\(\hat{\beta}(Y)\)是\(\beta\)的最小二乘估计量,则:

  1. 使\(c^{\top}\beta\)成为可估函数的全体向量\(c\)构成\(\mathcal{M}(X^{\top})\);

  2. 可估函数的全体构成一个\(\mathbb{R}\)上的\(\operatorname{rank}(X)\)维线性空间;

  3. \(c^{\top}\hat{\beta}(Y)\)与\((X^{\top}X)^-\)的选择无关;

  4. \(c^{\top}\hat{\beta}(Y)\)为\(c^{\top}\beta\)的无偏估计;

  5. \(\operatorname{Cov}[c^{\top}\hat{\beta}(Y),d^{\top}\hat{\beta}(Y)]=\sigma^2c^{\top}(X^{\top}X)^-d\)且与\((X^{\top}X)^-\)的选择无关;

  6. (Gauss-Markov)当\(\sigma^2>0\)时,在方差最小的意义下\(c^{\top}\hat{\beta}(Y)\)是\(c^{\top}\beta\)唯一的BLUE;

  7. 设\(\varphi_i=c_i^{\top}\beta,\;i=1,2,\dots,k\)都是可估函数,\(\alpha_1, \alpha_2, \dots, \alpha_{k}\in\mathbb{R}\),则\(\varphi=\sum\limits_{i=1}^{k}\alpha_i\varphi_i\)也是可估的,\(\hat{\varphi}(Y)=\sum\limits_{i=1}^{k}\alpha_ic_i^{\top}\hat{\beta}(Y)\)是\(\varphi\)的无偏估计。当当\(\sigma^2>0\)时,在方差最小的意义下\(\hat{\varphi}(Y)\)时\(\varphi\)唯一的BLUE。

证明. (1)由性质 5.4.3(6)和性质 2.1.2(4)可知\(c^{\top}\beta\)是可估函数\(\Leftrightarrow\)存在\(\alpha\in\mathbb{R}^{n}\)使得\(\operatorname{E}(\alpha^{\top}Y)=\alpha^{\top}\operatorname{E}(Y)=\alpha^{\top}X\beta=c^{\top}\beta\)对任意的\(\beta\)成立\(\Leftrightarrow c=X^{\top}\alpha\)。

(2)记函数族:

\[\begin{equation*} \mathcal{F}=\left\{f_c:f_c(\beta)=c^{\top}\beta,\;c\in\mathcal{M}(X^{\top})\right\} \end{equation*}\]

对任意\(f_{c_1},f_{c_2}\in\mathcal{F}\)和 \(a\in\mathbb{R}\),在\(\mathcal{F}\)上定义加法与数乘为:

\[\begin{gather*} (f_{c_1}+f_{c_2})(\beta)=f_{c_1}(\beta)+f_{c_2}(\beta) \\ (af_{c_1})(\beta)=af_{c_1}(\beta) \end{gather*}\]

可以验证\(\mathcal{F}\)是\(\mathbb{R}\)上的线性空间。

定义映射:

\[\begin{equation*} \pi:\mathcal{M}(X^{\top})\to\mathcal{F},\quad\pi(c)=f_c \end{equation*}\]

由性质 1.3.1(6)和\(\mathcal{F}\)的定义可知\(\pi\)是\(\mathcal{M}(X^{\top})\)到\(\mathcal{F}\)的一个同构映射,根据性质 1.1.7(6)、性质 1.1.5(3)和性质 2.1.8(7)可得:

\[\begin{equation*} \dim(\mathcal{F})=\dim\mathcal{M}(X^{\top})=\operatorname{rank}(X^{\top})=\operatorname{rank}(X) \end{equation*}\]

因此,可估函数的全体构成一个\(\mathbb{R}\)上的\(\operatorname{rank}(X)\)维线性空间。

(3)因为\(c^{\top}\beta\)可估,由(1)可知存在\(\alpha\in\mathbb{R}^{n}\)使得\(c=X^{\top}\alpha\),于是由性质 2.1.2(4)和定理 14.1可得:

\[\begin{equation*} c^{\top}\hat{\beta}(Y)=\alpha^{\top}X(X^{\top}X)^-X^{\top}Y \end{equation*}\]

由性质 2.5.1(4)即可得出结论。

(4)因为\(c^{\top}\beta\)可估,由(1)可知存在\(\alpha\in\mathbb{R}^{n}\)使得\(c=X^{\top}\alpha\),根据定理 14.1、性质 5.4.3(6)和性质 2.5.1(7)可得:

\[\begin{equation*} \operatorname{E}[c^{\top}\hat{\beta}(Y)]=\operatorname{E}[c^{\top}(X^{\top}X)^-X^{\top}Y]=c^{\top}(X^{\top}X)^-X^{\top}X\beta=c^{\top}\beta \end{equation*}\]

(5)因为\(c^{\top}\beta,d^{\top}\beta\)是可估函数,由(1)可知存在\(\alpha,\gamma\in\mathbb{R}^{n}\)使得\(c=X^{\top}\alpha,d=X^{\top}\gamma\)。根据定理 14.1、性质 6.4.3(3)、性质 2.1.2(4)和性质 2.5.1(7)(5)(4)可得:

\[\begin{align*} &\operatorname{Cov}[c^{\top}\hat{\beta}(Y),d^{\top}\hat{\beta}(Y)]=\operatorname{Cov}[c^{\top}(X^{\top}X)^-X^{\top}Y,d^{\top}(X^{\top}X)^-X^{\top}Y] \\ =&c^{\top}(X^{\top}X)^-X^{\top}\operatorname{Cov}(Y)X[(X^{\top}X)^-]^{\top}d =c^{\top}(X^{\top}X)^-X^{\top}\sigma^2I_nX[(X^{\top}X)^-]^{\top}d \\ =&\sigma^2c^{\top}(X^{\top}X)^-X^{\top}X[(X^{\top}X)^-]^{\top}d=\sigma^2c^{\top}[(X^{\top}X)^-]^{\top}d=\sigma^2\alpha^{\top}X[(X^{\top}X)^-]^{\top}X^{\top}\gamma \\ =&\sigma^2\alpha^{\top}X(X^{\top}X)^-X^{\top}\gamma=\sigma^2c^{\top}(X^{\top}X)^-d \end{align*}\]

根据性质 2.1.2(4)和定理 2.2可知\(c^{\top}=\alpha^{\top}X\in\mathcal{M}(X^{\top})=\mathcal{M}(X^{\top}X),d=X^{\top}\gamma\in\mathcal{M}(X^{\top})=\mathcal{M}(X^{\top}X)\),由性质 2.5.1(3)可得\(\operatorname{Cov}[c^{\top}\hat{\beta}(Y),d^{\top}\hat{\beta}(Y)]\)与\((X^{\top}X)^-\)的选择无关。

(6)无偏性由(4)可得,线性性由定理 14.1可知,下证方差最小。

设\(a^{\top}Y\)为\(c^{\top}\beta\)的任一无偏估计,由(1)的过程可知\(c=X^{\top}a\)。根据性质 6.4.3(3)和(5)可得:

\[\begin{equation*} \operatorname{Var}(a^{\top}Y)-\operatorname{Var}[c^{\top}\hat{\beta}(Y)]=\sigma^2[a^{\top}a-c^{\top}(X^{\top}X)^-c] \end{equation*}\]

由性质 2.1.2(4)和性质 2.5.1(7)可得:

\[\begin{align*} &[a^{\top}-c^{\top}(X^{\top}X)^-X^{\top}][a-X(X^{\top}X)^-c] \\ =&a^{\top}a-a^{\top}X(X^{\top}X)^-c-c^{\top}(X^{\top}X)^-X^{\top}a+c^{\top}(X^{\top}X)^-X^{\top}X(X^{\top}X)^-c \\ =&a^{\top}a-c^{\top}(X^{\top}X)^-c-c^{\top}(X^{\top}X)^-c+c^{\top}(X^{\top}X)^-c \\ =&a^{\top}a-c^{\top}(X^{\top}X)^-c \end{align*}\]

所以:

\[\begin{equation*} \operatorname{Var}(a^{\top}Y)=\sigma^2[a^{\top}-c^{\top}(X^{\top}X)^-X^{\top}][a-X(X^{\top}X)^-c] \end{equation*}\]

根据性质 2.1.2(4)和性质 2.5.1(5)(4)可得:

\[\begin{align*} [c^{\top}(X^{\top}X)^-X^{\top}]^{\top}&=X[(X^{\top}X)^-]^{\top}c=X[(X^{\top}X)^-]^{\top}X^{\top}a \\ &=X(X^{\top}X)^-X^{\top}a=X(X^{\top}X)^-c \end{align*}\]

于是:

\[\begin{equation*} \operatorname{Var}(a^{\top}Y)-\operatorname{Var}[c^{\top}\hat{\beta}(Y)]=\sigma^2||a-X(X^{\top}X)^-c||^2\geqslant0 \end{equation*}\]

所以\(\operatorname{Var}(a^{\top}Y)=\operatorname{Var}[c^{\top}\hat{\beta}(Y)]\)当且仅当\(a=X(X^{\top}X)^-c\),由定理 14.1可知\(a=X(X^{\top}X)^-c\Leftrightarrow a^{\top}=c^{\top}(X^{\top}X)^-X^{\top}\Leftrightarrow a^{\top}Y=c^{\top}(X^{\top}X)^-X^{\top}Y=c^{\top}\hat{\beta}(Y)\)。

(7)由(2)可知\(\varphi\)是可估的。

由(4)可得\(c_i^{\top}\hat{\beta}(Y)\)是\(c_i^{\top}\beta\)的无偏估计,根据性质 5.4.3(6)可得:

\[\begin{equation*} \operatorname{E}[\hat{\varphi}(Y)]=\operatorname{E}\left[\sum_{i=1}^{k}\alpha_ic_i^{\top}\hat{\beta}(Y)\right]=\sum_{i=1}^{k}\alpha_i\operatorname{E}[c_i^{\top}\hat{\beta}(Y)]=\sum_{i=1}^{k}\alpha_ic_i^{\top}\beta=\varphi \end{equation*}\]

即\(\hat{\varphi}(Y)\)是一个无偏估计。

令\(c=\sum\limits_{i=1}^{k}\alpha_ic_i\),则\(\varphi=c^{\top}\beta\)。设\(\gamma^{\top}Y\)是\(\varphi\)的一个无偏估计,于是由(6)可得:

\[\begin{equation*} \operatorname{Var}(\gamma^{\top}Y)-\operatorname{Var}[c^{\top}\hat{\beta}(Y)]=\sigma^2||\gamma-X(X^{\top}X)^-c||^2 \end{equation*}\]

上式等于\(0\Leftrightarrow \gamma^{\top}Y=c^{\top}\hat{\beta}(Y)=\hat{\varphi}(Y)\),即\(\hat{\varphi}(Y)\)是唯一的BLUE。 ◻

Definition 14.6. 对于定义 14.1,若\(c^{\top}\beta\)是可估函数,称\(c^{\top}\hat{\beta}(Y)\)为\(c^{\top}\beta\)的LSE,称\(c^{\top}\hat{\beta}(y)\)为该估计量在观测向量\(y\)处的观测值。

14.1.1.2 残差

Definition 14.7. 对于定义 14.1,记向\(\mathcal{M}(X)\)的正交投影阵为:

\[\begin{equation*} P_X\coloneq X(X^{\top}X)^-X^{\top}\in\mathbb{R}^{n\times n} \end{equation*}\]

定义随机拟合向量\(\widehat{Y}:\Omega\to\mathbb{R}^n\)及随机残差向量\(\widehat{E}:\Omega\to\mathbb{R}^n\)为:

\[\begin{equation*} \widehat{Y}\coloneq X\hat{\beta}(Y)=P_XY,\quad \widehat{E}\coloneq Y-\widehat{Y}=(I_n-P_X)Y \end{equation*}\]

称\(\widehat{E}\)为随机残差向量(residual vector)。它们在观测向量\(y\)处的观测值分别记为:

\[\begin{equation*} \hat{y}\coloneq X\hat{\beta}(y)=P_Xy,\quad \hat{e}\coloneq y-\hat{y}=(I_n-P_X)y \end{equation*}\]

称\(\hat{e}\)为观测残差向量。定义残差平方和(sum of squared residuals, SSE)函数:

\[\begin{equation*} \operatorname{SSE}(z)\coloneq z^{\top}(I_n-P_X)z,\quad z\in\mathbb{R}^n \end{equation*}\]

于是\(\operatorname{SSE}(Y)=\widehat{E}^{\top}\widehat{E}\)为随机变量,\(\operatorname{SSE}(y)=\hat{e}^{\top}\hat{e}\)为它在观测向量\(y\)处的观测值。

Property 14.1.2. 对于定义 14.1,随机拟合向量\(\widehat{Y}\)与随机残差向量\(\widehat{E}\)满足:

  1. \(\operatorname{E}(\widehat{E})=\mathbf{0}_n,\;\operatorname{Cov}(\widehat{E})=\sigma^2(I_n-P_X)\);

  2. \(\operatorname{SSE}(Y)=Y^{\top}(I_n-P_X)Y,\;\operatorname{SSE}(y)=y^{\top}(I_n-P_X)y\);

  3. \(\operatorname{Cov}(\widehat{Y},\widehat{E})=\mathbf{0}_{n\times n}\);

证明. (1)根据性质 2.8.2(7)(3)可知\(I_n-P_X\)是对称幂等阵,所以由性质 6.4.3(3)可得:

\[\begin{gather*} \begin{aligned} \operatorname{E}(\widehat{E})&=\operatorname{E}[(I_n-P_X)Y]=(I_n-P_X)\operatorname{E}(Y) \\ &=(I_n-P_X)X\beta=(X-X)\beta=\mathbf{0}_n \end{aligned} \\ \begin{aligned} \operatorname{Cov}(\widehat{E})&=\operatorname{Cov}[(I_n-P_X)Y]=(I_n-P_X)\operatorname{Cov}(Y)(I_n-P_X)^{\top} \\ &=(I_n-P_X)\operatorname{Cov}(Y)(I_n-P_X)=\sigma^2(I_n-P_X) \end{aligned} \end{gather*}\]

(2)因为\(I_n-P_X\)是对称幂等阵,所以对任意的\(z\in\mathbb{R}^n\),由性质 2.1.2(4)可得:

\[\begin{equation*} [(I_n-P_X)z]^{\top}(I_n-P_X)z=z^{\top}(I_n-P_X)^{\top}(I_n-P_X)z=z^{\top}(I_n-P_X)z \end{equation*}\]

(3)由性质 6.4.3(5)(3)和性质 2.8.2(2)(8)可得

\[\begin{align*} \operatorname{Cov}(\widehat{Y},\widehat{E})&=\operatorname{Cov}[P_XY,(I_n-P_X)Y] \\ &=P_X\operatorname{Cov}(Y)(I_n-P_X)=\sigma^2P_X(I_n-P_X)=\mathbf{0}_{n\times n} \end{align*}\]

◻

14.1.1.3 误差方差

Theorem 14.2. 对于定义 14.1,\(\operatorname{rank}(X)=r\),则随机变量:

\[\begin{equation*} \hat{\sigma}^2(Y)\coloneq\frac{\operatorname{SSE}(Y)}{n-r} \end{equation*}\]

是\(\sigma^2\)的无偏估计。

证明. 注意到\((I_n-P_X)X=X-X=\mathbf{0}\),由性质 14.1.2(2)、定理 6.6和性质 2.1.2(4)可得:

\[\begin{align*} \operatorname{E}[\operatorname{SSE}(Y)]&=\operatorname{E}[Y^{\top}(I_n-P_X)Y] =\beta^{\top}X^{\top}(I_n-P_X)X\beta+\operatorname{tr}[(I_n-P_X)\sigma^2I_n] \\ &=\sigma^2\operatorname{tr}(I_n-P_X) \end{align*}\]

由性质 2.8.2(7)(3)、性质 2.8.1(2)(5)和性质 2.8.2(1)可得:

\[\begin{equation*} \operatorname{tr}(I_n-P_X)=\operatorname{rank}(I_n-P_X)=n-\operatorname{rank}(P_X)=n-\operatorname{rank}(X)=n-r \end{equation*}\]

根据性质 5.4.3(6)即:

\[\begin{equation*} \operatorname{E}[\hat{\sigma}^2(Y)]=\operatorname{E}\left[\frac{\operatorname{SSE}(Y)}{n-r}\right]=\sigma^2 \end{equation*}\]

◻

Definition 14.8. 称\(\hat{\sigma}^2(Y)\)为\(\sigma^2\)的LSE,称:

\[\begin{equation*} \hat{\sigma}^2(y)\coloneq\frac{\operatorname{SSE}(y)}{n-r} \end{equation*}\]

为该估计量在观测向量\(y\)处的观测值。仅讨论观测值时,将\(\hat{\sigma}^2(y)\)简记为\(\hat{\sigma}^2\)。

14.1.2 约束最小二乘估计

引理 15.1 Lemma 14.1. 若\(A\in\mathbb{R}^{k\times p}\),\(\operatorname{rank}(A)=k\)且\(\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top})\),则\(A(X^{\top}X)^{-}A^{\top}\)正定,于是根据定理 2.17(6)可知\(A(X^{\top}X)^{-}A^{\top}\)可逆。

证明. 由定理 2.2可知\(\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top}X)\),于是存在\(B\in\mathbb{R}^{p\times k}\)使得\(A^{\top}=X^{\top}XB\)。根据性质 2.1.2(4)可得:

\[\begin{equation*} A(X^{\top}X)^{-}A^{\top}=B^{\top}X^{\top}X(X^{\top}X)^{-}X^{\top}XB=B^{\top}X^{\top}XB \end{equation*}\]

注意到对任意的\(x\in\mathbb{R}^k\)有\(x^{\top}B^{\top}X^{\top}XBx=||XBx||^2\geqslant0\)。若存在非零的\(x\in\mathbb{R}^k\)使得\(x^{\top}B^{\top}X^{\top}XBx=||XBx||^2=0\),则:

\[\begin{equation*} A^{\top}x=X^{\top}XBx=\mathbf{0} \end{equation*}\]

于是\(\operatorname{rank}(A)\ne k\),矛盾,所以\(A(X^{\top}X)^{-}A^{\top}\)正定。 ◻

Theorem 14.3. 对于定义 14.1,假设:

\[\begin{equation*} A\beta=b,\quad A\in\mathbb{R}^{k\times p},\quad b\in\mathbb{R}^k,\quad\operatorname{rank}(A)=k,\quad\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top}) \end{equation*}\]

且\(A\beta=b\)相容,则:

\[\begin{equation*} \hat{\beta}_A=\hat{\beta}-(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \end{equation*}\]

为\(\beta\)在约束\(A\beta=b\)下的约束LS解,\(A\hat{\beta}_A\)为\(A\beta\)的约束LSE。

证明. 使用Lagrange乘子法构造辅助函数(\(\lambda\)为Lagrange乘子,乘子前加上系数\(2\)是为了下面不出现分数,对结果没有影响):

\[\begin{align*} F(\beta,\lambda)&=||y-X\beta||^2+2\lambda^{\top}(A\beta-b) \\ &=y^{\top}y-y^{\top}X\beta-\beta^{\top}X^{\top}y+\beta^{\top}X^{\top}X\beta+2\lambda^{\top}A\beta-2\lambda^{\top}b \end{align*}\]

于是:

\[\begin{equation*} \frac{\partial F(\beta,\lambda)}{\partial\beta}=-2X^{\top}y+2X^{\top}X\beta+2A^{\top}\lambda \end{equation*}\]

令上式为\(0\),得到:

\[\begin{equation*} X^{\top}X\beta=X^{\top}y-A^{\top}\lambda \end{equation*}\]

于是约束下的解即为方程组:

\[\begin{equation*} \begin{cases} X^{\top}X\beta=X^{\top}y-A^{\top}\lambda \\ A\beta=b \end{cases} \end{equation*}\]

的解,将其记为\(\hat{\beta}_A,\hat{\lambda}\)。因为\(\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top})\),由定理 2.2和定理 2.4(1)可知方程组是相容的。由定理 2.11可知:

\[\begin{equation*} \hat{\beta}_A=(X^{\top}X)^-X^{\top}y-(X^{\top}X)^-A^{\top}\hat{\lambda}=\hat{\beta}-(X^{\top}X)^-A^{\top}\hat{\lambda} \end{equation*}\]

代入方程组的第二个方程可得:

\[\begin{equation*} A\hat{\beta}-A(X^{\top}X)^-A^{\top}\hat{\lambda}=b \end{equation*}\]

由引理 14.1可知:

\[\begin{equation*} \hat{\lambda}=[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \end{equation*}\]

于是:

\[\begin{equation*} \hat{\beta}_A=\hat{\beta}-(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \end{equation*}\]

下证明这个解确实是最小二乘解。

做分解:

\[\begin{align*} ||y-X\beta||^2 &=||y-X\hat{\beta}+X(\hat{\beta}-\beta)||^2 \\ &=||y-X\hat{\beta}||^2+2(y-X\hat{\beta})^{\top}X(\hat{\beta}-\beta)+(\hat{\beta}-\beta)^{\top}X^{\top}X(\hat{\beta}-\beta) \end{align*}\]

由性质 2.1.2和性质 2.5.1(5)(6)可得:

\[\begin{align*} (y-X\hat{\beta})^{\top}X(\hat{\beta}-\beta)&=y^{\top}X(\hat{\beta}-\beta)-\hat{\beta}^{\top}X^{\top}X(\hat{\beta}-\beta) \\ &=y^{\top}X(\hat{\beta}-\beta)-[(X^{\top}X)^-X^{\top}y]^{\top}X^{\top}X(\hat{\beta}-\beta) \\ &=y^{\top}X(\hat{\beta}-\beta)-y^{\top}X(X^{\top}X)^-X^{\top}X(\hat{\beta}-\beta) \\ &=y^{\top}X(\hat{\beta}-\beta)-y^{\top}X(\hat{\beta}-\beta)=0 \end{align*}\]

于是:

\[\begin{align*} ||y-X\beta||^2 &=||y-X\hat{\beta}||^2+(\hat{\beta}-\beta)^{\top}X^{\top}X(\hat{\beta}-\beta) \\ &=||y-X\hat{\beta}||^2+(\hat{\beta}-\hat{\beta}_A+\hat{\beta}_A-\beta)^{\top}X^{\top}X(\hat{\beta}-\hat{\beta}_A+\hat{\beta}_A-\beta) \\ &=||y-X\hat{\beta}||^2+||X(\hat{\beta}-\hat{\beta}_A)||^2+||X(\hat{\beta}_A-\beta)||^2+2(\hat{\beta}-\hat{\beta}_A)^{\top}X^{\top}X(\hat{\beta}_A-\beta) \end{align*}\]

由性质 2.5.1(5)(7)以及\(\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top})\)可得:

\[\begin{align*} (\hat{\beta}-\hat{\beta}_A)^{\top}X^{\top}X(\hat{\beta}_A-\beta) &=[(X^{\top}X)^-A^{\top}\hat{\lambda}]^{\top}X^{\top}X(\hat{\beta}_A-\beta) =\hat{\lambda}^{\top}A(X^{\top}X)^-X^{\top}X(\hat{\beta}_A-\beta) \\ &=\hat{\lambda}^{\top}A(\hat{\beta}_A-\beta) =\hat{\lambda}^{\top}(A\hat{\beta}_A-A\beta)=0 \end{align*}\]

所以:

\[\begin{equation*} ||y-X\beta||^2=||y-X\hat{\beta}||^2+||X(\hat{\beta}-\hat{\beta}_A)||^2+||X(\hat{\beta}_A-\beta)||^2 \end{equation*}\]

即对任意满足\(A\beta=b\)的\(\beta\)都有:

\[\begin{equation*} ||y-X\beta||^2\geqslant||y-X\hat{\beta}||^2+||X(\hat{\beta}-\hat{\beta}_A)||^2 \end{equation*}\]

等号成立当且仅当\(\beta=\hat{\beta}_A\),于是\(\hat{\beta}_A\)是LSE。 ◻

Definition 14.9. 在定理 14.3的假设下,对任意\(z\in\mathbb{R}^n\)定义约束最小二乘估计映射:

\[\begin{equation*} \hat{\beta}_A(z)\coloneq\hat{\beta}(z)-(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A\hat{\beta}(z)-b] \end{equation*}\]

并定义约束残差平方和函数:

\[\begin{equation*} \operatorname{SSE}_A(z)\coloneq||z-X\hat{\beta}_A(z)||^2 \end{equation*}\]

于是\(\hat{\beta}_A(Y)\)与\(\operatorname{SSE}_A(Y)\)是随机对象,\(\hat{\beta}_A(y)\)与\(\operatorname{SSE}_A(y)\)是它们在观测向量\(y\)处的观测值。仅讨论观测值时,将\(\hat{\beta}_A(y)\)简记为\(\hat{\beta}_A\)。

14.1.2.1 误差方差

Theorem 14.4. 在定理 14.3的假设下,在参数区域\(A\beta=b\)上,

\[\begin{equation*} \hat{\sigma}_A^2(Y)\coloneq\frac{||Y-X\hat{\beta}_A(Y)||^2}{n-r+k}=\frac{\operatorname{SSE}_A(Y)}{n-r+k} \end{equation*}\]

是\(\sigma^2\)的无偏估计。

证明. 由定理 14.3可知:

\[\begin{equation*} \operatorname{E}[||Y-X\hat{\beta}_A(Y)||^2]=\operatorname{E}\{||Y-X\hat{\beta}(Y)||^2+||X[\hat{\beta}(Y)-\hat{\beta}_A(Y)]||^2\} =\operatorname{E}[||Y-X\hat{\beta}(Y)||^2]+\operatorname{E}\{||X[\hat{\beta}(Y)-\hat{\beta}_A(Y)]||^2\} \end{equation*}\]

根据定理 14.2可知:

\[\begin{equation*} \operatorname{E}[||Y-X\hat{\beta}(Y)||^2]=(n-r)\sigma^2 \end{equation*}\]

由性质 2.5.1(5)(7)、\(\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top})\)

\[\begin{align*} ||X[\hat{\beta}(Y)-\hat{\beta}_A(Y)]||&=[\hat{\beta}(Y)-\hat{\beta}_A(Y)]^{\top}X^{\top}X[\hat{\beta}(Y)-\hat{\beta}_A(Y)] \\ &=\{(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A\hat{\beta}(Y)-b]\}^{\top} \\ &\quad\cdot X^{\top}X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A\hat{\beta}(Y)-b] \\ &=[A\hat{\beta}(Y)-b]^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^- \\ &\quad\cdot X^{\top}X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A\hat{\beta}(Y)-b] \\ &=[A\hat{\beta}(Y)-b]^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A\hat{\beta}(Y)-b] \\ &=[A\hat{\beta}(Y)-b]^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A\hat{\beta}(Y)-b] \end{align*}\]

因为\(\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top})\),所以由性质 14.1.1(1)可知\(A\beta\)的每一个元素都是可估函数,于是由定理 6.6和性质 14.1.1(4)(5)可知:

\[\begin{align*} \operatorname{E}\{||X[\hat{\beta}(Y)-\hat{\beta}_A(Y)]||\} &=\operatorname{E}\{[A\hat{\beta}(Y)-b]^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A\hat{\beta}(Y)-b]\} \\ &=(A\beta-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\beta-b) \\ &\quad+\operatorname{tr}\{[A(X^{\top}X)^-A^{\top}]^{-1}\operatorname{Cov}[A\hat{\beta}(Y)-b]\} \\ &=\operatorname{tr}\{[A(X^{\top}X)^-A^{\top}]^{-1}\sigma^2A(X^{\top}X)^-A^{\top}\}=\sigma^2\operatorname{tr}(I_k)=k\sigma^2 \end{align*}\]

所以:

\[\begin{equation*} \operatorname{E}[||Y-X\hat{\beta}_A(Y)||^2]=(n-r+k)\sigma^2 \end{equation*}\]

即在参数区域\(A\beta=b\)上,

\[\begin{equation*} \hat{\sigma}_A^2(Y)=\frac{||Y-X\hat{\beta}_A(Y)||^2}{n-r+k} \end{equation*}\]

是\(\sigma^2\)的无偏估计。 ◻

Definition 14.10. 称:

\[\begin{equation*} \hat{\sigma}_A^2(y)\coloneq\frac{\operatorname{SSE}_A(y)}{n-r+k} \end{equation*}\]

为\(\hat{\sigma}_A^2(Y)\)在观测向量\(y\)处的观测值。仅讨论观测值时,将\(\hat{\sigma}_A^2(y)\)简记为\(\hat{\sigma}_A^2\)。

14.1.3 实际计算

Theorem 14.5. 对于无约束条件以及约束\(A\beta=\mathbf{0}\),有:

\[\begin{gather*} \operatorname{SSE}(y)=||y-X\hat{\beta}||^2=y^{\top}y-\hat{\beta}^{\top}X^{\top}y,\quad \operatorname{SSE}_A(y)=||y-X\hat{\beta}_A||^2=y^{\top}y-\hat{\beta}_A^{\top}X^{\top}y \end{gather*}\]

证明. 由性质 2.5.1(6)可知:

\[\begin{align*} \operatorname{SSE}(y)&=(y-X\hat{\beta})^{\top}(y-X\hat{\beta})=y^{\top}y-y^{\top}X\hat{\beta}-\hat{\beta}^{\top}X^{\top}y+\hat{\beta}^{\top}X^{\top}X\hat{\beta} \\ &=y^{\top}y-2\hat{\beta}^{\top}X^{\top}y+\hat{\beta}^{\top}X^{\top}X(X^{\top}X)^-X^{\top}y=y^{\top}y-2\hat{\beta}^{\top}X^{\top}y+\hat{\beta}^{\top}X^{\top}y \\ &=y^{\top}y-\hat{\beta}^{\top}X^{\top}y \end{align*}\]

由定理 14.3可知:

\[\begin{equation*} \begin{cases} X^{\top}X\hat{\beta}_A=X^{\top}y-A^{\top}\hat{\lambda} \\ A\hat{\beta}_A=\mathbf{0} \end{cases} \end{equation*}\]

其中\(\lambda\)为Lagrange乘子,于是有:

\[\begin{align*} \operatorname{SSE}_A(y)&=(y-X\hat{\beta}_A)^{\top}(y-X\hat{\beta}_A)=y^{\top}y-y^{\top}X\hat{\beta}_A-\hat{\beta}_A^{\top}X^{\top}y+\hat{\beta}_A^{\top}X^{\top}X\hat{\beta}_A \\ &=y^{\top}y-\hat{\beta}_A^{\top}X^{\top}y+\hat{\beta}_A^{\top}X^{\top}X\hat{\beta}_A-\hat{\beta}_A^{\top}X^{\top}y=y^{\top}y-\hat{\beta}_A^{\top}X^{\top}y+\hat{\beta}_A^{\top}(X^{\top}X\hat{\beta}_A-X^{\top}y) \\ &=y^{\top}y-\hat{\beta}_A^{\top}X^{\top}y-\hat{\beta}_A^{\top}A^{\top}\hat{\lambda}=y^{\top}y-\hat{\beta}_A^{\top}X^{\top}y \end{align*}\]

◻

Definition 14.11. 称\(\hat{\beta}^{\top}X^{\top}y=y^{\top}P_Xy\)为回归平方和(regression sum of suqares, RSS),记为\(\operatorname{RSS}(y)\)。称\(\hat{\beta}_A^{\top}X^{\top}y\)为约束条件\(A\beta=\mathbf{0}\)下的回归平方和,记为\(\operatorname{RSS}_A(y)\)。称\(y^{\top}y\)为总平方和,记作\(\operatorname{RSS}_{\text{总}}\)。称\(\sqrt{\dfrac{\operatorname{RSS}(y)}{\operatorname{RSS}_{\text{总}}}}\)为\(y\)与设计矩阵\(X\)的列向量之间的复相关系数,记作\(\operatorname{R}\)。

Property 14.1.3. \(\operatorname{RSS}_{\text{总}}=\operatorname{RSS}(y)+\operatorname{SSE}(y)\)。

证明. 由性质 14.1.2(2)可得\(\operatorname{RSS}(y)+\operatorname{SSE}(y)=y^{\top}P_Xy+y^{\top}(I_n-P_X)y=y^{\top}y=\operatorname{RSS}_{\text{总}}\)。 ◻

note 14.3. 回归平方和表示了数据平方和\(y^{\top}y\)中能够由因变量\(y\)与设计矩阵\(X\)的列向量之间的线性关系解释的部分,因为它是\(y\)在\(\mathcal{M}(X)\)上投影长度的平方。由此可以看出\(\operatorname{R}^2\leqslant1\)。我们用\(\operatorname{R}^2\)来度量设计矩阵\(X\)对\(y\)线性拟合程度的好坏,越接近\(1\)越好。

14.1.4 预测

假设要预测\(m\)个点\(x_{0i}=(x_{0i1},x_{0i2},\dots,x_{0ip}),\;i=1,2,\dots,m\),它们所对应的因变量组成随机向量\(Y_0:\Omega\to\mathbb{R}^m\)。假设\(Y_0\)和历史数据服从同一个线性模型,即:

\[\begin{gather*} Y_0=X_0\beta+\varepsilon_0,\quad\operatorname{E}(\varepsilon_0)=\mathbf{0}_m,\quad\operatorname{Cov}(\varepsilon_0)=\sigma^2I_m \\ Y_0= \begin{pmatrix} Y_{01} \\ Y_{02} \\ \vdots \\ Y_{0m} \end{pmatrix},\quad X_0= \begin{pmatrix} x_{011} & x_{012} & \cdots & x_{01p} \\ x_{021} & x_{022} & \cdots & x_{02p} \\ \vdots & \vdots & \ddots & \vdots \\ x_{0m1} & x_{0m2} & \cdots & x_{0mp} \end{pmatrix},\quad \varepsilon_0= \begin{pmatrix} \varepsilon_{01} \\ \varepsilon_{02} \\ \vdots \\ \varepsilon_{0m} \end{pmatrix} \end{gather*}\]

其中\(X_0\in\mathbb{R}^{m\times p}\)为非随机设计矩阵,\(\varepsilon_0:\Omega\to\mathbb{R}^m\)为随机误差向量。对固定的\(\omega\in\Omega\),将随机向量\(Y_0\)的一次观测实现记为\(y_0\coloneq Y_0(\omega)=(y_{01},y_{02},\dots,y_{0m})^{\top}\in\mathbb{R}^m\);此后\(y_0\)表示给定的非随机向量。 假设\(\mathcal{M}(X_0^{\top})\subseteq\mathcal{M}(X^{\top})\)。

14.1.4.1 被测量与历史数据无关

Derivation 14.2. 此时使用\(\operatorname{E}(Y_0)=X_0\beta\)的估计去进行预测,记相应的随机预测量及其在观测向量\(y\)处的观测值分别为:

\[\begin{equation*} \widehat{Y}_0\coloneq X_0\hat{\beta}(Y),\quad \hat{y}_0\coloneq X_0\hat{\beta}(y) \end{equation*}\]

由定理 2.2可知\(\mathcal{M}(X^{\top})=\mathcal{M}(X^{\top}X)\),于是\(\mathcal{M}(X_0^{\top})\subseteq\mathcal{M}(X^{\top})=\mathcal{M}(X^{\top}X)\),由性质 2.5.1(3)可知\(X_0\hat{\beta}(y)=X_0(X^{\top}X)^-X^{\top}y\)与广义逆\((X^{\top}X)^-\)的选择无关。

因为\(\mathcal{M}(X_0^{\top})\subseteq\mathcal{M}(X^{\top})\),所以\(X_0\beta\)是可估的,它具有可估函数的性质。但需注意,因为\(Y_0\)也是一个随机向量,所以这里的无偏性指的是\(\operatorname{E}(\widehat{Y}_0-Y_0)=\mathbf{0}_m\)。

14.1.4.2 被测量与历史数据相关

Derivation 14.3. 在某些情况下,\(Y_0\)和\(Y\)确实具有一定的相关性,设非随机矩阵\(V\in\mathbb{R}^{m\times n}\),用\(\operatorname{Cov}(\varepsilon,\varepsilon_0)=\sigma^2V^{\top}\)来度量它们之间的相关性,此时有:

\[\begin{equation*} \operatorname{Cov} \begin{pmatrix} Y \\ Y_0 \end{pmatrix} =\operatorname{Cov} \begin{pmatrix} \varepsilon \\ \varepsilon_0 \end{pmatrix} =\sigma^2 \begin{pmatrix} I_n & V^{\top} \\ V & I_m \end{pmatrix} \end{equation*}\]

Definition 14.12. 对任意非随机矩阵\(C\in\mathbb{R}^{m\times n}\),记\(\widehat{Y}_0\coloneq CY\)为\(Y_0\)的一个线性无偏预测量,记\(\hat{y}_0\coloneq Cy\)为该预测量在观测向量\(y\)处的观测值。称:

\[\begin{equation*} \operatorname{PMSE}(\widehat{Y}_0)\coloneq\operatorname{E}[(\widehat{Y}_0-Y_0)^{\top}A(\widehat{Y}_0-Y_0)] \end{equation*}\]

为广义预测均方误差(generalized prediction MSE, PMSE),其中\(A\in\mathbb{R}^{m\times m}\)为非随机正定矩阵。

Theorem 14.6. \(Y_0\)在广义预测均方误差意义下的最优线性无偏预测量为:

\[\begin{equation*} \widehat{Y}_0=X_0\hat{\beta}(Y)+V[Y-X\hat{\beta}(Y)] \end{equation*}\]

其在观测向量\(y\)处的观测值为:

\[\begin{equation*} \hat{y}_0=X_0\hat{\beta}(y)+V[y-X\hat{\beta}(y)] \end{equation*}\]

证明. 令\(\widehat{Y}_0=CY\)是一个无偏预测量,由性质 5.4.3(6)和性质 6.4.3(3)可得:

\[\begin{gather*} \widehat{Y}_0-Y_0=CY-X_0\beta-\varepsilon_0=CX\beta+C\varepsilon-X_0\beta-\varepsilon_0=(CX-X_0)\beta+C\varepsilon-\varepsilon_0 \\ \operatorname{E}(\widehat{Y}_0-Y_0)=(CX-X_0)\beta=\mathbf{0}_m\text{对一切$\beta$成立}\iff CX=X_0 \\ \begin{aligned} \operatorname{Cov}(C\varepsilon-\varepsilon_0)&=\operatorname{E}[(C\varepsilon-\varepsilon_0)(C\varepsilon-\varepsilon_0)^{\top}]=\operatorname{E}(C\varepsilon\varepsilon^{\top}C^{\top}-C\varepsilon\varepsilon_0^{\top}-\varepsilon_0\varepsilon^{\top}C^{\top}+\varepsilon_0\varepsilon_0^{\top}) \\ &=\operatorname{E}(C\varepsilon\varepsilon^{\top}C^{\top})-\operatorname{E}(C\varepsilon\varepsilon_0^{\top})-\operatorname{E}(\varepsilon_0\varepsilon^{\top}C^{\top})+\operatorname{E}(\varepsilon_0\varepsilon_0^{\top}) \\ &=C\operatorname{E}(\varepsilon\varepsilon^{\top})C^{\top}-\operatorname{Cov}(C\varepsilon,\varepsilon_0)-\operatorname{Cov}(\varepsilon_0,C\varepsilon)+\operatorname{Cov}(\varepsilon_0) \\ &=C\operatorname{Cov}(\varepsilon)C^{\top}-2\operatorname{Cov}(C\varepsilon,\varepsilon_0)+\sigma^2I_m \\ &=\sigma^2CC^{\top}-2C\operatorname{Cov}(\varepsilon,\varepsilon_0)+\sigma^2I_m \\ &=\sigma^2CC^{\top}-2\sigma^2CV^{\top}+\sigma^2I_m=\sigma^2(CC^{\top}-2CV^{\top}+I_m) \end{aligned} \end{gather*}\]

由定理 6.6和性质 2.1.5(2)可得:

\[\begin{align*} \operatorname{PMSE}(\widehat{Y}_0)&=\operatorname{E}[(\widehat{Y}_0-Y_0)^{\top}A(\widehat{Y}_0-Y_0)] =\operatorname{E}[(C\varepsilon-\varepsilon_0)^{\top}A(C\varepsilon-\varepsilon_0)] \\ &=\operatorname{tr}[A\sigma^2(CC^{\top}-2CV^{\top}+I_m)] =\sigma^2\operatorname{tr}[A(CC^{\top}-2CV^{\top}+I_m)] \end{align*}\]

接下来的目标就是求解:

\[\begin{equation*} \min_{C}\operatorname{PMSE}(\widehat{Y}_0),\quad\operatorname{s.t.}CX=X_0 \end{equation*}\]

使用Lagrange乘子法,构造辅助函数(不引入\(X_0\)是因为它是常数,对结果没影响):

\[\begin{equation*} F(C,\varLambda)=\sigma^2\operatorname{tr}[A(CC^{\top}-2CV^{\top}+I_m)]-2\operatorname{tr}(CX\varLambda) \end{equation*}\]

其中\(\varLambda\in\mathbb{R}^{p\times m}\)是Lagrange乘子。由矩阵求导和性质 2.1.5(1)可得:

\[\begin{align*} \frac{\partial F(C,\varLambda)}{\partial C}&=\sigma^2\frac{\partial\operatorname{tr}(ACC^{\top})}{\partial C}-2\sigma^2\frac{\partial\operatorname{tr}(ACV^{\top})}{\partial C}-2\frac{\partial\operatorname{tr}(CX\varLambda)}{\partial C} \\ &=\sigma^22AC-2\sigma^2AV-2\varLambda^{\top}X^{\top} \end{align*}\]

令上式为\(0\)可得:

\[\begin{gather*} \sigma^2AC=\sigma^2AV+\varLambda^{\top}X^{\top} \\ C=V+\frac{A^{-1}\varLambda^{\top}X^{\top}}{\sigma^2} \end{gather*}\]

代入\(CX=X_0\)可得:

\[\begin{equation*} VX+\frac{A^{-1}\varLambda^{\top}X^{\top}X}{\sigma^2}=X_0 \\ \varLambda^{\top}X^{\top}X=\sigma^2A(X_0-VX) \\ X^{\top}X\varLambda=\sigma^2(X_0^{\top}-X^{\top}V^{\top})A^{\top} \end{equation*}\]

由定理 2.2可知\(\mathcal{M}(X^{\top})=\mathcal{M}(X^{\top}X)\),而\(\mathcal{M}(X_0^{\top})\subseteq\mathcal{M}(X^{\top})\),所以上式等式右边矩阵的每一列都在\(\mathcal{M}(X^{\top}X)\)中,即方程组是相容的。由定理 2.11可得:

\[\begin{equation*} \varLambda=\sigma^2(X^{\top}X)^-(X_0^{\top}-X^{\top}V^{\top})A^{\top} \end{equation*}\]

于是由性质 2.5.1(5)可得:

\[\begin{align*} C&=V+A^{-1}A(X_0-VX)(X^{\top}X)^-X^{\top}=V+(X_0-VX)(X^{\top}X)^-X^{\top} \\ &=X_0(X^{\top}X)^-X^{\top}+V[I_n-X(X^{\top}X)^-X^{\top}] \end{align*}\]

由性质 2.5.1(3)(4)可知\(C\)是唯一的,与\((X^{\top}X)^-\)的选择无关。所以:

\[\begin{equation*} \widehat{Y}_0=X_0(X^{\top}X)^-X^{\top}Y+V[I_n-X(X^{\top}X)^-X^{\top}]Y=X_0\hat{\beta}(Y)+V[Y-X\hat{\beta}(Y)] \end{equation*}\]

为\(Y_0\)在广义预测均方误差意义下的最优线性无偏预测量。 ◻

14.2 正态线性模型

14.2.1 参数估计

Definition 14.13. 称以下模型为正态线性模型(normal linear model):

\[\begin{equation*} \begin{cases} y=X\beta+\varepsilon \\ \varepsilon\sim\operatorname{N}_n(\mathbf{0},\sigma^2I_n) \end{cases} \end{equation*}\]

其中\(y\)为\(n\times 1\)观测向量,\(X\)为\(n\times p\)设计矩阵,\(\beta\)为\(p\times 1\)未知参数向量,\(\varepsilon\)为随机误差,\(\sigma^2\)为误差方差。

Property 14.2.1. 对于定义 14.13,设\(c^{\top}\beta\)为可估函数,则:

  1. LS估计\(c^{\top}\hat{\beta}\)是\(c^{\top}\beta\)的MLE,\(\tilde{\sigma}^2=\dfrac{n-r}{n}\hat{\sigma}^2\)是\(\sigma^2\)的MLE。若模型在定理 14.3的约束下,则LS估计\(c^{\top}\hat{\beta}_A\)是\(c^{\top}\beta\)的MLE,\(\tilde{\sigma}_A^2=\dfrac{n-r+k}{n}\hat{\sigma}_A^2\)是\(\sigma^2\)的MLE;

  2. \(c^{\top}\hat{\beta}\sim N[c^{\top}\beta,\sigma^2c^{\top}(X^{\top}X)^-c]\),\(\dfrac{(n-r)\hat{\sigma}^2}{\sigma^2}=\dfrac{\operatorname{SSE}}{\sigma^2}\sim\chi_{n-r}^2\);

  3. \(c^{\top}\hat{\beta}\)与\(\hat{\sigma}^2\)相互独立;

  4. \(T_1=y^{\top}y,\;T_2=X^{\top}y\)为\(y\)的分布族的完全充分统计量;

  5. 若\(c^{\top}\beta\)和\(\sigma^2\)的估计的损失函数是估计量的严格凸函数,则\(c^{\top}\hat{\beta}\)是\(c^{\top}\beta\)在几乎处处的意义下唯一的UMRUE,\(\hat{\sigma}^2\)为\(\sigma^2\)在几乎处处的意义下唯一的UMRUE;

  6. \(\hat{e}\sim\operatorname{N}_n[\mathbf{0},\sigma^2(I_n-P_X)]\)。

证明. (1)对于定义 14.13,其似然函数为:

\[\begin{equation*} L(\beta,\sigma^2)=\frac{1}{(2\pi)^{\frac{n}{2}}(\sigma^2)^\frac{n}{2}}\exp\left(-\frac{1}{2\sigma^2}||y-X\beta||^2\right) \end{equation*}\]

于是对数似然函数为:

\[\begin{equation*} \ln L(\beta,\sigma^2)=-\frac{n}{2}\ln2\pi-\frac{n}{2}\ln\sigma^2-\frac{1}{2\sigma^2}||y-X\beta||^2 \end{equation*}\]

固定\(\sigma^2\)时,由最小二乘法原理可知:

\[\begin{equation*} ||y-X\hat{\beta}||^2=\min||y-X\beta||^2 \end{equation*}\]

当\(\beta=\hat{\beta}\)时有:

\[\begin{equation*} \ln L(\hat{\beta},\sigma^2)=-\frac{n}{2}\ln2\pi-\frac{n}{2}\ln\sigma^2-\frac{1}{2\sigma^2}||y-X\hat{\beta}||^2 \end{equation*}\]

由极值点的必要条件可知:

\[\begin{gather*} \frac{\mathop{}\!\mathrm{d}\ln L(\hat{\beta},\sigma^2)}{\mathop{}\!\mathrm{d}\sigma^2}=-\frac{n}{2\sigma^2}+\frac{||y-X\hat{\beta}||^2}{2\sigma^4} \\ \tilde{\sigma}^2=\frac{1}{n}||y-X\hat{\beta}||^2 \end{gather*}\]

时对数似然函数取极值,注意到:

\[\begin{gather*} \frac{\mathop{}\!\mathrm{d}^2\ln L(\hat{\beta},\sigma^2)}{\mathop{}\!\mathrm{d}(\sigma^2)^2}=\frac{n}{2\sigma^4}-\frac{||y-X\hat{\beta}||^2}{\sigma^6} \\ \begin{aligned} \frac{\mathop{}\!\mathrm{d}^2\ln L(\hat{\beta},\sigma^2)}{\mathop{}\!\mathrm{d}(\sigma^2)^2}\Big|_{\sigma^2=\tilde{\sigma}^2}&=\frac{n^3}{2||y-X\hat{\beta}||^4}-\frac{||y-X\hat{\beta}||^2n^3}{||y-X\hat{\beta}||^6} \\ &=\frac{n^3}{2||y-X\hat{\beta}||^4}-\frac{n^3}{||y-X\hat{\beta}||^4}=-\frac{n^3}{2||y-X\hat{\beta}||^4}<0 \end{aligned} \end{gather*}\]

于是此处取极大值。因为:

\[\begin{equation*} \tilde{\sigma}^2=\frac{1}{n}||y-X\hat{\beta}||^2=\frac{n-r}{n}\hat{\sigma}^2 \end{equation*}\]

所以\(\tilde{\sigma}^2\)是\(\sigma^2\)的MLE。由上可知\(\hat{\beta}\)是\(\beta\)的MLE,根据性质 10.3.1(1)可得\(c^{\top}\hat{\beta}\)是\(c^{\top}\beta\)的MLE。

约束条件下的情况与上述证明过程类似。

(2)因为\(\varepsilon\sim\operatorname{N}_n(\mathbf{0},\sigma^2I_n)\),而\(c^{\top}\hat{\beta}=c^{\top}(X^{\top}X)^-X^{\top}y=c^{\top}(X^{\top}X)^-X^{\top}(X\beta+\varepsilon)\)。因为\(c^{\top}\beta\)是可估函数,所以由性质 14.1.1(1)可知存在\(\alpha\)使得\(c=X^{\top}\alpha\),根据性质 2.5.1(7)可知:

\[\begin{equation*} c^{\top}(X^{\top}X)^-X^{\top}X\beta=c^{\top}\beta \end{equation*}\]

由性质 2.5.1(5)(7)可知:

\[\begin{equation*} c^{\top}(X^{\top}X)^-X^{\top}[c^{\top}(X^{\top}X)^-X^{\top}]^{\top}=c^{\top}(X^{\top}X)^-X^{\top}X(X^{\top}X)^-c=c^{\top}(X^{\top}X)^-c \end{equation*}\]

于是由性质 6.5.8(2)可得:

\[\begin{equation*} c^{\top}\hat{\beta}\sim\operatorname{N}[c^{\top}\beta,c^{\top}(X^{\top}X)^-c] \end{equation*}\]

因为\((I_n-P_X)X=\mathbf{0}\),根据性质 2.8.2(7)(3)可得\(I_n-P_X\)是对称阵,所以由性质 14.1.2(2)、性质 2.8.2(8)和性质 2.1.2(4)可知:

\[\begin{align*} \frac{n-r}{\sigma^2}\hat{\sigma}^2&=\frac{\hat{e}^{\top}\hat{e}}{\sigma^2}=\frac{y^{\top}(I_n-P_X)y}{\sigma^2} \\ &=\frac{(X\beta+\varepsilon)^{\top}(I_n-P_X)(X\beta+\varepsilon)}{\sigma^2} \\ &=\frac{(X\beta+\varepsilon)^{\top}(I_n-P_X)X\beta+(X\beta+\varepsilon)^{\top}(I_n-P_X)\varepsilon}{\sigma^2} \\ &=\frac{(X\beta+\varepsilon)^{\top}(I_n-P_X)\varepsilon}{\sigma^2}=\frac{\beta^{\top}X^{\top}(I_n-P_X)\varepsilon+\varepsilon^{\top}(I_n-P_X)\varepsilon}{\sigma^2} \\ &=\frac{\beta^{\top}[(I_n-P_X)^{\top}X]^{\top}\varepsilon+\varepsilon^{\top}(I_n-P_X)\varepsilon}{\sigma^2}=\frac{\varepsilon^{\top}(I_n-P_X)\varepsilon}{\sigma^2} \end{align*}\]

因为\(\varepsilon\sim\operatorname{N}_n(\mathbf{0},\sigma^2I_n)\),由性质 6.5.8(2)可知\(\dfrac{\varepsilon}{\sigma}\sim\operatorname{N}_n(\mathbf{0},I_n)\)。根据性质 2.8.2(7)(3)可知\(I_n-P_X\)是对称幂等阵,由性质 2.8.1(5)和性质 2.8.2(1)可得\(\operatorname{rank}(I_n-P_X)=n-r\),于是根据定理 6.9可得:

\[\begin{equation*} \frac{n-r}{\sigma^2}\hat{\sigma}^2=\frac{\varepsilon^{\top}(I_n-P_X)\varepsilon}{\sigma^2}\sim\chi_{n-r}^2 \end{equation*}\]

(3)由性质 14.1.2(2)可知:

\[\begin{equation*} c^{\top}\hat{\beta}=c^{\top}(X^{\top}X)^-X^{\top}y,\quad\hat{\sigma}^2=\frac{y^{\top}(I_n-P_X)y}{n-r} \end{equation*}\]

因为\(c^{\top}\beta\)是可估函数,所以存在\(\alpha\)使得\(c=X^{\top}\alpha\),由性质 2.1.2(4)、性质 2.1.1(2)和性质 2.8.2(8)可得:

\[\begin{align*} c^{\top}(X^{\top}X)^-X^{\top}\operatorname{Cov}(y)\frac{I_n-P_X}{n-r}&=\frac{\sigma^2}{n-r}\alpha^{\top}X(X^{\top}X)^-X^{\top}(I_n-P_X) \\ &=\frac{\sigma^2}{n-r}\alpha^{\top}P_X(I_n-P_X)=\mathbf{0} \end{align*}\]

由定理 6.10可知\(c^{\top}\hat{\beta}\)与\(\hat{\sigma}^2\)独立。

(4)由性质 6.5.8(1)(2)和性质 2.1.2(4)可知观测向量\(y\)的概率函数为:

\[\begin{align*} &p(y)=(2\pi\sigma^2)^{-\frac{n}{2}}\exp\left[-\frac{1}{2}(y-X\beta)^{\top}\frac{1}{\sigma^2}(y-X\beta)\right] \\ =&(2\pi\sigma^2)^{-\frac{n}{2}}\exp\left[-\frac{1}{2\sigma^2}(y^{\top}y-y^{\top}X\beta-\beta^{\top}X^{\top}y-\beta^{\top}X^{\top}X\beta)\right] \\ =&(2\pi\sigma^2)^{-\frac{n}{2}}\exp(\beta^{\top}X^{\top}X\beta)\exp\left(-\frac{1}{2\sigma^2}y^{\top}y-\frac{\beta^{\top}}{\sigma^2}X^{\top}y\right) \end{align*}\]

所以\(y\)的分布族为指数族,自然参数为\(\left(-\dfrac{1}{2\sigma^2},-\dfrac{\beta^{\top}}{\sigma^2}\right)\),自然参数空间为\(\mathbb{R}^{-}\times\mathbb{R}^{p}\),所以它是满秩的。由性质 9.1.5(8)可知\(T_1=y^{\top}y,T_2=X^{\top}y\)是分布族的完全充分统计量。

(5)由性质 14.1.1(4)可知\(c^{\top}\hat{\beta}=c^{\top}(X^{\top}X)^-X^{\top}y\)是\(c^{\top}\beta\)的无偏估计,根据(4)可得\(c^{\top}\hat{\beta}\)是完全充分统计量\(X^{\top}y\)的函数,由定理 10.2可知\(c^{\top}\hat{\beta}\)是\(c^{\top}\beta\)在几乎处处的意义下唯一的UMRUE。由定理 14.2和性质 14.1.2(2)可知\(\hat{\sigma}^2=\dfrac{\operatorname{SSE}}{n-r}=\dfrac{y^{\top}y-y^{\top}X(X^{\top}X)^-X^{\top}y}{n-r}\)是\(\sigma^2\)的无偏估计,根据(4)可得\(\hat{\sigma}^2\)是完全充分统计量\(y^{\top}y\)和\(X^{\top}y\)的函数,由定理 10.2可知\(\hat{\sigma}^2\)是\(\sigma^2\)在几乎处处的意义下唯一的UMRUE。

(6)由性质 14.1.2(1)和性质 6.5.8(2)立即可得。 ◻

14.2.2 假设检验

Theorem 14.7. 对于定义 14.13,假设:

\[\begin{equation*} A\beta=b,\quad A\in M_{k\times p}(K),\quad\operatorname{rank}(A)=k,\quad\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top}) \end{equation*}\]

且\(A\beta=b\)相容,则:

  1. 似然比检验\(H_0:A\beta=b,\;H_1:A\beta\ne b\)的似然比为:

    \[\begin{equation*} \lambda(y)=\left(\frac{\operatorname{SSE}_A}{\operatorname{SSE}}\right)^\frac{n}{2} \end{equation*}\]

  2. \(\dfrac{\operatorname{SSE}_A-\operatorname{SSE}}{\sigma^2}\sim\chi^2_{k,\alpha}\),其中:

    \[\begin{equation*} \alpha=\frac{(A\beta-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\beta-b)}{\sigma^2} \end{equation*}\]

  3. \(\operatorname{SSE}_A-\operatorname{SSE}\)与\(\operatorname{SSE}\)相互独立;

  4. 当\(A\beta=b\)为真时,

    \[\begin{equation*} F=\frac{(\operatorname{SSE}_A-\operatorname{SSE})/k}{\operatorname{SSE}/(n-r)}\sim\operatorname{F}_{k,n-r} \end{equation*}\]

    且上式左侧为\(\lambda(y)\)的单调增函数;

  5. 似然比检验\(H_0:A\beta=b,\;H_1:A\beta\ne b\)置信水平为\(1-\alpha\)的拒绝域为\(\{F:F>\operatorname{F}_{k,n-r}(1-\alpha)\}\);

证明. (1)由性质 14.2.1(1)可知:

\[\begin{gather*} \begin{aligned} \sup_{\beta,\sigma}L(\beta,\sigma^2;y)&=L(\hat{\beta},\tilde{\sigma}^2;y)=(2\pi)^{-\frac{n}{2}}(\tilde{\sigma}^2)^{-\frac{n}{2}}\exp\left(-\frac{||y-X\hat{\beta}||^2}{2\tilde{\sigma}^2}\right) \\ &=(2\pi)^{-\frac{n}{2}}\left(\frac{||y-X\hat{\beta}||^2}{n}\right)^{-\frac{n}{2}}\exp\left(-\frac{n||y-X\hat{\beta}||^2}{2||y-X\hat{\beta}||^2}\right) \\ &=(2\pi)^{-\frac{n}{2}}\left(\frac{||y-X\hat{\beta}||^2}{n}\right)^{-\frac{n}{2}}\exp\left(-\frac{n}{2}\right)=\left(\frac{2\pi e}{n}\right)^{-\frac{n}{2}}||y-X\hat{\beta}||^{-n} \end{aligned} \\ \sup_{A\beta=b,\sigma^2}L(\beta,\sigma^2;y)=L(\hat{\beta}_A,\tilde{\sigma}_A^2;y)=\left(\frac{2\pi e}{n}\right)^{-\frac{n}{2}}||y-X\hat{\beta}_A||^{-n} \end{gather*}\]

于是:

\[\begin{equation*} \lambda(y)=\frac{L(\hat{\beta},\tilde{\sigma}^2;y)}{L(\hat{\beta}_A,\tilde{\sigma}_A^2;y)}=\left(\frac{\operatorname{SSE}_A}{\operatorname{SSE}}\right)^\frac{n}{2} \end{equation*}\]

(2)根据性质 2.1.2(4)、性质 2.1.10(12)、性质 2.5.1(5)(7)和性质 2.8.2(7)(3)对\(\operatorname{SSE}_A\)作分解:

\[\begin{align*} \operatorname{SSE}_A&=||y-X\hat{\beta}_A||^2=\Big\|y-X\{\hat{\beta}-(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b)\}\Big\|^2 \\ &=\Big\|y-X\hat{\beta}+X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b)\Big\|^2 \\ &=\operatorname{SSE}+2(y-X\hat{\beta})^{\top}X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &\quad+\{X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b)\}^{\top} \\ &\quad\cdot X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &=\operatorname{SSE}+2[y-X(X^{\top}X)^-X^{\top}y]^{\top}X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &\quad+(A\hat{\beta}-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-X^{\top} \\ &\quad\cdot X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &=\operatorname{SSE}+2[(I_n-P_X)y]^{\top}X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &\quad+(A\hat{\beta}-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &=\operatorname{SSE}+2y^{\top}(I_n-P_X)X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &\quad+(A\hat{\beta}-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &=\operatorname{SSE}+(A\hat{\beta}-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \end{align*}\]

所以有:

\[\begin{equation*} \operatorname{SSE}_A-\operatorname{SSE}=(A\hat{\beta}-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \end{equation*}\]

由性质 14.2.1(2)和性质 6.5.8(2)可知:

\[\begin{equation*} A\hat{\beta}-b\sim\operatorname{N}_k[A\beta-b,\sigma^2A(X^{\top}X)^-A^{\top}] \end{equation*}\]

根据引理 14.1可知\(A(X^{\top}X)^-A^{\top}\)存在平方根阵及平方根阵的逆矩阵,由性质 6.5.8(2)可知:

\[\begin{equation*} \frac{[A(X^{\top}X)^-A^{\top}]^{-\frac{1}{2}}}{\sigma}(A\hat{\beta}-b)\sim\operatorname{N}_k\left\{\frac{[A(X^{\top}X)^-A^{\top}]^{-\frac{1}{2}}}{\sigma}(A\beta-b),I_k\right\} \end{equation*}\]

于是由\(\chi^2\)分布的定义可得:

\[\begin{equation*} \frac{\operatorname{SSE}_A-\operatorname{SSE}}{\sigma^2}=\frac{\{[A(X^{\top}X)^-A^{\top}]^{-\frac{1}{2}}(A\hat{\beta}-b)\}^{\top}[A(X^{\top}X)^-A^{\top}]^{-\frac{1}{2}}(A\hat{\beta}-b)}{\sigma^2}\sim\chi_{k,\alpha}^2 \end{equation*}\]

其中:

\[\begin{align*} \alpha&=(\sigma^2)^{-1}\{[A(X^{\top}X)^-A^{\top}]^{-\frac{1}{2}}(A\beta-b)\}^{\top}[A(X^{\top}X)^-A^{\top}]^{-\frac{1}{2}}(A\beta-b) \\ &=(\sigma^2)^{-1}(A\beta-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\beta-b) \end{align*}\]

(3)由性质 14.1.2(2)可知\(\operatorname{SSE}=y^{\top}(I_n-P_X)y\),由(2)的过程和性质 2.1.2(4)可得:

\[\begin{align*} \operatorname{SSE}_A-\operatorname{SSE}&=(A\hat{\beta}-b)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-b) \\ &=[A(X^{\top}X)^-X^{\top}y-b]^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}[A(X^{\top}X)^-X^{\top}y-b] \\ &=y^{\top}X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-X^{\top}y \\ &\quad-2b^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-X^{\top}y+b^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}b \\ &=y^{\top}By-Cy+c \end{align*}\]

因为\((I_n-P_X)X=\mathbf{0}\),由性质 2.8.2(7)(3)和性质 2.1.2(4)可得:

\[\begin{gather*} (I_n-P_X)B=(I_n-P_X)X(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-X^{\top}=\mathbf{0} \\ \begin{aligned} &C(I_n-P_X)=2b^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-X^{\top}(I_n-P_X) \\ =&2b^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-[(I_n-P_X)X]^{\top}=\mathbf{0} \end{aligned} \end{gather*}\]

于是根据定理 6.10和定理 6.11可知\(\operatorname{SSE}_A-\operatorname{SSE}\)与\(\operatorname{SSE}\)独立。

(4)当\(A\beta=b\)为真时,由(2)可知\(\dfrac{\operatorname{SSE}_A-\operatorname{SSE}}{\sigma^2}\sim\chi^2_{k}\)。根据(3)和性质 14.2.1(2)可得:

\[\begin{equation*} \frac{(\operatorname{SSE}_A-\operatorname{SSE})/(k\sigma^2)}{\operatorname{SSE}/[(n-r)\sigma^2]}=\frac{(\operatorname{SSE}_A-\operatorname{SSE})/k}{\operatorname{SSE}/(n-r)}\sim\operatorname{F}_{k,n-r} \end{equation*}\]

由(1)可得:

\[\begin{equation*} \frac{(\operatorname{SSE}_A-\operatorname{SSE})/k}{\operatorname{SSE}/(n-r)}=\frac{n-r}{k}[\lambda^{\frac{2}{n}}(y)-1] \end{equation*}\]

所以它是\(\lambda(y)\)的单调增函数。

(5)由(1)(4)可立即得出。 ◻

14.2.3 置信域

14.2.3.1 置信椭球

Theorem 14.8. 对于定义 14.13,若不能接受假设\(A\beta=\mathbf{0}\),则\(A\beta\)置信水平为\(1-\alpha\)的置信椭球为:

\[\begin{equation*} \{A\beta:(A\beta-A\hat{\beta})^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\beta-A\hat{\beta})\leqslant k\hat{\sigma}^2F_{k,n-r}(1-\alpha)\} \end{equation*}\]

证明. 由性质 14.2.1(2)可知:

\[\begin{equation*} A\hat{\beta}\sim\operatorname{N}[A\beta,\sigma^2A(X^{\top}X)^-A^{\top}] \end{equation*}\]

所以:

\[\begin{equation*} \frac{A\hat{\beta}-A\beta}{\sigma}\sim\operatorname{N}[\mathbf{0},A(X^{\top}X)^-A^{\top}] \end{equation*}\]

因为:

\[\begin{equation*} [A(X^{\top}X)^-A^{\top}]^{-1}A(X^{\top}X)^-A^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}=[A(X^{\top}X)^-A^{\top}]^{-1} \end{equation*}\]

所以由定理 6.9可知:

\[\begin{equation*} \frac{(A\hat{\beta}-A\beta)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-A\beta)}{\sigma^2}\sim\chi_{k}^2 \end{equation*}\]

根据性质 14.2.1(2)(3)可得:

\[\begin{align*} &\frac{(A\hat{\beta}-A\beta)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-A\beta)}{k\sigma^2}\Big/\frac{(n-r)\hat{\sigma}^2}{(n-r)\sigma^2} \\ =&\frac{(A\hat{\beta}-A\beta)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-A\beta)}{k\hat{\sigma}^2}\sim F_{k,n-r} \end{align*}\]

所以对任意的\(0<\alpha<1\),有:

\[\begin{equation*} P\left[\frac{(A\hat{\beta}-A\beta)^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\hat{\beta}-A\beta)}{k\hat{\sigma}^2}\leqslant F_{k,n-r}(1-\alpha)\right]=1-\alpha \end{equation*}\]

即\(A\beta\)置信水平为\(1-\alpha\)的置信椭球为:

\[\begin{equation*} \{A\beta:(A\beta-A\hat{\beta})^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\beta-A\hat{\beta})\leqslant k\hat{\sigma}^2F_{k,n-r}(1-\alpha)\} \end{equation*}\]

◻

note 14.4. 这里其实是一个未知方差构造\(F\)分布的思想。

14.2.3.2 Scheffe置信区间

Theorem 14.9. 对于定义 14.13,对任何可估函数\(l^{\top}\beta\),其中\(l\in\mathcal{M}(A^{\top})\)且\(l\ne\mathbf{0}\),其置信水平为\(1-\alpha\)的同时置信区间为:

\[\begin{equation*} l^{\top}\hat{\beta}\pm[k\hat{\sigma}^2F_{k,n-r}(1-\alpha)l^{\top}(X^{\top}X)^-l]^{\frac{1}{2}} \end{equation*}\]

证明. 由定理 14.8、引理 14.1与不等式 2可知:

\[\begin{align*} 1-\alpha&=P\left[(A\beta-A\hat{\beta})^{\top}[A(X^{\top}X)^-A^{\top}]^{-1}(A\beta-A\hat{\beta})\leqslant k\hat{\sigma}^2F_{k,n-r}(1-\alpha)\right] \\ &=P\left\{\sup_{b\ne\mathbf{0}}\frac{[(A\hat{\beta}-A\beta)^{\top}b]^2}{b^{\top}A(X^{\top}X)^-A^{\top}b}\leqslant k\hat{\sigma}^2F_{k,n-r}(1-\alpha)\right\} \\ &=P\left\{\frac{[(A\hat{\beta}-A\beta)^{\top}b]^2}{b^{\top}A(X^{\top}X)^-A^{\top}b}\leqslant k\hat{\sigma}^2F_{k,n-r}(1-\alpha),\;\text{对任意的}b\ne\mathbf{0}\right\} \\ &=P\left\{|(A\hat{\beta}-A\beta)^{\top}b|\leqslant [k\hat{\sigma}^2F_{k,n-r}(1-\alpha)b^{\top}A(X^{\top}X)^-A^{\top}b]^{\frac{1}{2}},\;\text{对任意的}b\ne\mathbf{0}\right\} \\ &=P\left\{|\hat{\beta}^{\top}A^{\top}b-\beta^{\top}A^{\top}b|\leqslant [k\hat{\sigma}^2F_{k,n-r}(1-\alpha)b^{\top}A(X^{\top}X)^-A^{\top}b]^{\frac{1}{2}},\;\text{对任意的}b\ne\mathbf{0}\right\} \end{align*}\]

记\(A^{\top}b=l\),因为\(\mathcal{M}(A^{\top})\subseteq\mathcal{M}(X^{\top})\),由性质 14.1.1(1)可知\(l^{\top}\beta\)也是一个可估函数,于是有:

\[\begin{equation*} 1-\alpha=P\left\{|l^{\top}\hat{\beta}-l^{\top}\beta|\leqslant [k\hat{\sigma}^2F_{k,n-r}(1-\alpha)l^{\top}(X^{\top}X)^-l]^{\frac{1}{2}},\;\text{对任意的}l\in\mathcal{M}(A^{\top})\text{且}l\ne\mathbf{0}\right\} \end{equation*}\]

◻

14.2.3.3 Bonferroni置信区间

Theorem 14.10. 对于定义 14.13,记\(A\)的行分别为\(a^{\top}_1, a^{\top}_2, \dots, a^{\top}_{k}\),则\(a_ i^{\top}\beta\)置信水平为\(1-\alpha\)的Bonferroni置信区间为:

\[\begin{equation*} a_i^{\top}\hat{\beta}\pm t_{n-r}\left(1-\frac{\alpha}{2k}\right)[\hat{\sigma}^2a_i^{\top}(X^{\top}X)^-a_i]^{\frac{1}{2}} \end{equation*}\]

证明. 由定理 14.8可得当\(k=1\)时有:

\[\begin{align*} 1-\alpha&=P\left\{(a_i^{\top}\beta-a_i^{\top}\hat{\beta})^{\top}[a_i^{\top}(X^{\top}X)^-a_i]^{-1}(a_i^{\top}\beta-a_i^{\top}\hat{\beta})\leqslant\hat{\sigma}^2F_{1,n-r}(1-\alpha)\right\} \\ &=P\left\{(a_i^{\top}\beta-a_i^{\top}\hat{\beta})^2\leqslant\hat{\sigma}^2F_{1,n-r}(1-\alpha)[a_i^{\top}(X^{\top}X)^-a_i]\right\} \end{align*}\]

由性质 6.5.10(2)可知\(F_{1,n-r}=t^2_{n-r}\),因为服从\(\operatorname{t}\)分布的变量可取负值而服从\(\operatorname{F}\)分布的变量只能为正值,所以上式把平方变成绝对值时应修改对应的\(\alpha\)为\(\dfrac{a}{2}\),即此时:

\[\begin{equation*} 1-\alpha=P\left\{|a_i^{\top}\beta-a_i^{\top}\hat{\beta}|\leqslant t_{n-r}\left(1-\frac{\alpha}{2}\right)[\hat{\sigma}^2a_i^{\top}(X^{\top}X)^-a_i]^{\frac{1}{2}}\right\} \end{equation*}\]

由Bonferroni校正法可得出结论。 ◻

14.2.3.4 比较

Derivation 14.4. Scheffe区间与Bonferroni区间哪个更好?由二者的公式可以看出只需选择:

\[\begin{equation*} \min\left\{[k\hat{\sigma}^2F_{k,n-r}(1-\alpha)]^{\frac{1}{2}},\hat{\sigma}t_{n-r}\left(1-\frac{\alpha}{2k}\right)\right\} \end{equation*}\]

对应的方法即能得到更短的置信区间。

14.2.4 区间预测

Theorem 14.11. 延续14.1.4处的定义,假设\(\varepsilon\sim\operatorname{N}(0,\sigma^2I_n),\;\varepsilon_0\sim\operatorname{N}(0,\sigma^2I_m)\),且有

\[\begin{equation*} \operatorname{Cov}[(y,y_0)^{\top}]=\operatorname{Cov}[(\varepsilon,\varepsilon_0)^{\top}]=\sigma^2 \begin{pmatrix} I_n & V^{\top} \\ V & I_m \end{pmatrix} \end{equation*}\]

则\(y_0^{(i)}\)的Scheffe置信区间与Bonferroni置信区间分别为:

\[\begin{equation*} \hat{y}_0^{(i)}\pm[m\hat{\sigma}^2F_{m,n-r}(1-\alpha)T_{ii}]^{\frac{1}{2}},\quad \hat{y}_0^{(i)}\pm t_{n-r}\left(1-\frac{\alpha}{2m}\right)\hat{\sigma}(T_{ii})^{\frac{1}{2}} \end{equation*}\]

其中\(y_0^{(i)},\hat{y}_0^{(i)}\)表示的是\(y_0,\hat{y}_0\)的第\(i\)个分量,\(\hat{y}_0\)由定理 14.6给出,\(T_{ii}\)表示矩阵\(T\)的\(i,i\)元,\(T=(X_0-VX)(X^{\top}X)^-(X_0-VX)^{\top}+I_m-VV^{\top}\)。

证明. 由定理 14.6、性质 6.5.8(2)、性质 6.4.3(3)(5)和性质 2.5.1(5)(7)(5)可得:

\[\begin{equation*} \hat{y}_0=X_0\hat{\beta}+V(y-X\hat{\beta})\sim\operatorname{N}_m(X_0\beta,\sigma^2VV^{\top}) \end{equation*}\]

\[\begin{align*} \operatorname{Cov}(\hat{y}_0)&=\operatorname{Cov}(Cy)=C\operatorname{Cov}(y)C^{\top}=\sigma^2CC^{\top} \\ &=\sigma^2[X_0(X^{\top}X)^-X^{\top}+V-VX(X^{\top}X)^-X^{\top}] \\ &\quad\cdot[X(X^{\top}X)^-X_0^{\top}+V^{\top}-X(X^{\top}X)^-X^{\top}V^{\top}] \\ &=\sigma^2[X_0(X^{\top}X)^-X^{\top}X(X^{\top}X)^-X_0^{\top}+X_0(X^{\top}X)^-X^{\top}V^{\top} \\ &\quad-X_0(X^{\top}X)^-X^{\top}X(X^{\top}X)^-X^{\top}V^{\top}+VX(X^{\top}X)^-X_0^{\top} \\ &\quad+VV^{\top}-VX(X^{\top}X)^-X^{\top}V^{\top}-VX(X^{\top}X)^-X^{\top}X(X^{\top}X)^-X_0^{\top} \\ &\quad-VX(X^{\top}X)^-X^{\top}V^{\top}+VX(X^{\top}X)^-X^{\top}X(X^{\top}X)^-X^{\top}V^{\top}] \\ &=\sigma^2[X_0(X^{\top}X)^-X_0^{\top}+X_0(X^{\top}X)^-X^{\top}V^{\top}-X_0(X^{\top}X)^-X^{\top}V^{\top} \\ &\quad+VX(X^{\top}X)^-X_0^{\top}+VV^{\top}-VX(X^{\top}X)^-X^{\top}V^{\top} \\ &\quad-VX(X^{\top}X)^-X_0^{\top}-VX(X^{\top}X)^-X^{\top}V^{\top}+VX(X^{\top}X)^-X^{\top}V^{\top}] \\ &=\sigma^2[X_0(X^{\top}X)^-X_0^{\top}+VV^{\top}-VX(X^{\top}X)^-X^{\top}V^{\top}] \end{align*}\]

\[\begin{align*} \operatorname{Cov}(\hat{y}_0,y_0) &=\operatorname{Cov}[X_0\hat{\beta}+V(y-X\hat{\beta}),y_0]=\operatorname{Cov}[Vy+(X_0-VX)\hat{\beta},y_0] \\ &=V\operatorname{Cov}(y,y_0)+(X_0-VX)\operatorname{Cov}(\hat{\beta},y_0) \\ &=V\operatorname{Cov}(y,y_0)+(X_0-VX)\operatorname{Cov}[(X^{\top}X)^-X^{\top}y,y_0] \\ &=V\operatorname{Cov}(y,y_0)+(X_0-VX)(X^{\top}X)^-X^{\top}\operatorname{Cov}\operatorname{Cov}(y,y_0) \\ &=[V+(X_0-VX)(X^{\top}X)^-X^{\top}]\operatorname{Cov}(y,y_0) \\ &=\sigma^2[V+(X_0-VX)(X^{\top}X)^-X^{\top}]V^{\top} \end{align*}\]

令\(A=X_0(X^{\top}X)^-X_0^{\top}+VV^{\top}-VX(X^{\top}X)^-X^{\top}V^{\top},\;B=[V+(X_0-VX)(X^{\top}X)^-X^{\top}]V^{\top}\),所以:

\[\begin{equation*} \begin{pmatrix} \hat{y}_0 \\ y_0 \end{pmatrix}\sim\operatorname{N}_{m+n}\left[ \begin{pmatrix} X_0\beta \\ X_0\beta \end{pmatrix},\sigma^2 \begin{pmatrix} A & B \\ B^{\top} & I_m \end{pmatrix} \right] \end{equation*}\]

由性质 6.5.8(2)可知:

\[\begin{equation*} \hat{y}_0-y_0= (1,-1) \begin{pmatrix} \hat{y}_0 \\ y_0 \end{pmatrix}\sim\operatorname{N}_m\{ \mathbf{0},\sigma^2[(X_0-VX)(X^{\top}X)^-(X_0-VX)+I_m-VV^{\top}]\} \end{equation*}\]

令\(T=(X_0-VX)(X^{\top}X)^-(X_0-VX)^{\top}+I_m-VV^{\top}\),仿照定理 14.8中的推导能得到此时\(\hat{y}_0-y_0\)置信水平为\(1-\alpha\)的置信椭球为:

\[\begin{equation*} [\hat{y}_0-y_0:(\hat{y}_0-y_0)^{\top}(T)^{-1}(\hat{y}_0-y_0)\leqslant m\hat{\sigma}^2F_{m,n-r}(1-\alpha)] \end{equation*}\]

其中\(T\)的可逆性由T的可逆性证明保证。

由上述置信椭球,仿照定理 14.9的推导,在其中取\(b\)为标准基向量即可得到\(y_0^{(i)}\)的Scheffe置信区间为:

\[\begin{equation*} \hat{y}_0^{(i)}\pm[m\hat{\sigma}^2F_{m,n-r}(1-\alpha)T_{ii}]^{\frac{1}{2}} \end{equation*}\]

同理可得到\(y_0^{(i)}\)的Bonferroni置信区间为:

\[\begin{equation*} \hat{y}_0^{(i)}\pm t_{n-r}\left(1-\frac{\alpha}{2m}\right)\hat{\sigma}(T_{ii})^{\frac{1}{2}} \end{equation*}\]

◻

14.3 误差协方差推广

在很多情况下线性模型误差的协方差矩阵都不是\(\sigma^2I_n\)的形式。

14.3.1 广义最小二乘估计

Definition 14.14. 称以下模型为广义线性模型(generalized linear model):

\[\begin{equation*} \begin{cases} y=X\beta+\varepsilon \\ \operatorname{E}(\varepsilon)=\mathbf{0} \\ \operatorname{Cov}(\varepsilon)=\sigma^2\Sigma \end{cases} \end{equation*}\]

其中\(y\)为\(n\times 1\)观测向量,\(X\)为\(n\times p\)设计矩阵,\(\beta\)为\(p\times 1\)未知参数向量,\(\varepsilon\)为随机误差,\(\sigma^2\Sigma\)为误差协方差矩阵且\(\Sigma>\mathbf{0}\)。

Derivation 14.5. 因为\(\Sigma>\mathbf{0}\),所以存在\(\Sigma^{-\frac{1}{2}}\)。令:

\[\begin{equation*} y^{\star}=\Sigma^{-\frac{1}{2}}y,\quad X^{\star}=\Sigma^{-\frac{1}{2}}X,\quad\varepsilon^{\star}=\Sigma^{-\frac{1}{2}}\varepsilon \end{equation*}\]

由性质 6.4.3(3)可知定义 14.14可化作:

\[\begin{equation*} \begin{cases} y^{\star}=X^{\star}\beta+\varepsilon^{\star} \\ \operatorname{E}(\varepsilon^{\star})=\mathbf{0} \\ \operatorname{Cov}(\varepsilon^{\star})=\sigma^2I_n \end{cases} \end{equation*}\]

于是我们可以将广义线性模型化作线性模型来处理,由于可估函数的定义与协方差矩阵无关,所以对于线性模型与正态线性模型的那些结论,广义线性模型也可得到。

14.3.2 最小二乘统一理论

当\(\Sigma\)不是正定矩阵的时候,广义最小二乘估计失效,最小二乘统一理论解决了这一问题。

Lemma 14.2. 对于模型:

\[\begin{equation*} \begin{cases} y=X\beta+\varepsilon \\ \operatorname{E}(\varepsilon)=\mathbf{0} \\ \operatorname{Cov}(\varepsilon)=\sigma^2\Sigma \end{cases} \end{equation*}\]

其中\(y\)为\(n\times 1\)观测向量,\(X\)为\(n\times p\)设计矩阵,\(\beta\)为\(p\times 1\)未知参数向量,\(\varepsilon\)为随机误差,\(\sigma^2\Sigma\)为误差协方差矩阵,有如下结论:

  1. \(y\in\mathcal{\Sigma,X}\);

证明. 由性质 6.4.3(2)可得\(\Sigma\geqslant0\),根据性质 2.6.3(3)、性质 2.1.11(1)和性质 2.1.2(4)可知:

\[\begin{equation*} \Sigma=Q\operatorname{diag}\{\lambda_1, \lambda_2, \dots, \lambda_{n}\}Q^{\top}=Q\operatorname{diag}\{\lambda^{\frac{1}{2}}_1, \lambda^{\frac{1}{2}}_2, \dots, \lambda^{\frac{1}{2}}_{n}\}\operatorname{diag}\{\lambda^{\frac{1}{2}}_1, \lambda^{\frac{1}{2}}_2, \dots, \lambda^{\frac{1}{2}}_{n}\}Q^{\top}\coloneq LL^{\top} \end{equation*}\]

记\(\varepsilon=Le\),则 ◻

14.4 数值计算

本节介绍线性模型的实际数值计算问题,即在2025年的今天,我们在计算机中到底使用着怎样的方法去求解定义 14.1中的参数。

14.4.1 QR分解

对于定义 14.1,其最小二乘解满足:

\[\begin{equation*} \hat{\beta}=\underset{\beta}{\arg\min}||y-X\beta||^2 \end{equation*}\]

\(X\)可逆时:对\(X\)作QR分解:

\[\begin{equation*} ||y-X\beta||^2=||y-QR\beta||^2=[Q^{\top}(y-QR\beta)]^{\top}Q^{\top}(y-QR\beta)=||Q^{\top}y-R\beta||^2 \end{equation*}\]

因为\(X\)可逆,所以此时\(R\)是可逆的,由性质 2.1.10(3)和定理 2.4可知存在\(\beta\in\mathbb{R}^{p}\)使得\(R\beta=Q^{\top}y\)。因为\(R\)是一个上三角矩阵,所以通过Gaussian迭代法可方便地计算得到\(\beta\)。

\(X\)不可逆时:此时\(R\)必然可以呈现为前\(\operatorname{rank}(X)\)行构成上三角矩阵后\(n-\operatorname{rank}(X)\)行为零向量,即对角元素为\(0\),所以此时\(R\)可以分解为:

\[\begin{equation*} R= \begin{pmatrix} R_1 & R_2 \\ \mathbf{0} & \mathbf{0} \end{pmatrix} \end{equation*}\]

这样的形式,其中\(R_1\in M_{n-\operatorname{rank}(X)}(\mathbb{R})\)是上三角矩阵,只需对此时的\(Q\)矩阵也进行分块就可以将问题转化为可逆时的情况。我们得想办法让\(R\)矩阵呈现出上面的样子,由定理 2.20和定理 2.24中的内容,只需通过矩阵\(P\)作变换\(XP\)(\(P\)调换\(X\)中列向量之间的顺序)使得\(XP\)的第一列为\(X\)的列范数最大的列、\(XP\)的第二列为\(X\)去掉第一行后列范数最大的列……即可,这是由于我们选取的Householder变换让向量变为第一个元素为该向量的范数其它分量都为\(0\)的列向量,且Householder变换不改变后面向量的长度,这样一来就可以使得\(XP\)进行\(QR\)分解后得到的\(R\)的主对角元依次减小,主对角线为\(0\)的列对应的参数也无需再进行估计。

note 14.5. 其实在实际情况中\(X\)都是不可逆的,\(n\)总是大于\(p\)的。

14.4.2 SVD分解

14.5 线性回归模型

Definition 14.15. 设因变量\(Y\)和自变量\(X_1, X_2, \dots, X_{p-1}\)满足:

\[\begin{equation*} Y=\beta_0+\beta_1X_1+\beta_2X_2+\cdots+\beta_{p-1}X_{p-1}+e \end{equation*}\]

若对因变量\(Y\)和自变量\(X_1, X_2, \dots, X_{p-1}\)进行了\(n\)次观察,得到\(n\)组数据,它们满足:

\[\begin{equation*} y_i=\beta_0+\beta_1x_{i1}+\beta_2x_{i2}+\cdots+\beta_{p-1}x_{ip-1}+\varepsilon_i,\quad i=1,2,\dots,n \end{equation*}\]

记:

\[\begin{equation*} y= \begin{pmatrix} y_1 \\ y_2 \\ \vdots \\ y_n \end{pmatrix},\quad X= \begin{pmatrix} 1 & x_{11} & \cdots & x_{1p-1} \\ 1 & x_{21} & \cdots & x_{2p-1} \\ \vdots & \vdots & \ddots & \vdots \\ 1 & x_{n1} & \cdots & x_{np-1} \\ \end{pmatrix},\quad \beta= \begin{pmatrix} \beta_0 \\ \beta_1 \\ \vdots \\ \beta_{p-1} \end{pmatrix},\quad \varepsilon= \begin{pmatrix} \varepsilon_1 \\ \varepsilon_2 \\ \vdots \\ \varepsilon_n \end{pmatrix} \end{equation*}\]

且假设\(\operatorname{rank}(X)=p,\;\operatorname{E}(\varepsilon)=\mathbf{0},\;\operatorname{Cov}(\varepsilon)=\sigma^2I_n\),则得到线性回归模型(linear regression model):

\[\begin{equation*} y=X\beta+\varepsilon,\quad\operatorname{E}(\varepsilon)=\mathbf{0},\quad\operatorname{Cov}(\varepsilon)=\sigma^2I_n \end{equation*}\]

称\(\beta_0\)为常数项,\(\beta_I=(\beta_1, \beta_2, \dots, \beta_{p-1})^{\top}\)为回归系数。若记\(X=(\mathbf{1}_n,\tilde{X})\),其中\(\mathbf{1}_n\)为由\(n\)个\(1\)构成的列向量,则线性回归模型可被改写为:

\[\begin{equation*} y=\beta_0\mathbf{1}_n+\tilde{X}\beta_I+\varepsilon,\quad\operatorname{E}(\varepsilon)=\mathbf{0},\quad\operatorname{Cov}(\varepsilon)=\sigma^2I_n \end{equation*}\]

Definition 14.16. 对于定义 14.15,若\(\varepsilon\sim\operatorname{N}_n(\mathbf{0},\sigma^2I_n)\),则称此时的线性回归模型为正态线性回归模型(normal linear regression model)。

14.5.0.1 中心化与标准化处理

Definition 14.17. 对于定义 14.15,记:

\[\begin{equation*} \overline{x}_j=\frac{1}{n}\sum_{i=1}^{n}x_{ij},\quad s_j^2=\sum_{i=1}^{n}(x_{ij}-\overline{x}_j)^2 \end{equation*}\]

称:

\[\begin{gather*} y_i=\alpha_0+\alpha_1(x_{i1}-\overline{x}_1)+\alpha_2(x_{i2}-\overline{x}_2)+\cdots+\alpha_{p-1}(x_{ip-1}-\overline{x}_{p-1})+\varepsilon_i \\ y=\alpha_0\mathbf{1}_n+\tilde{X}_c\alpha_I+\varepsilon,\quad\operatorname{E}(\varepsilon)=\mathbf{0},\quad\operatorname{Cov}(\varepsilon)=\sigma^2I_n \end{gather*}\]

为中心化线性回归模型(centralized linear regression model),其中\(\tilde{X}_c=\left(I_n-\dfrac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\right)\tilde{X}\)(请证明该结论)被称为中心化设计矩阵(centralized design matrix),第二行是第一行的矩阵表示。

称:

\[\begin{gather*} y_i=\gamma_0+\gamma_1\frac{x_{i1}-\overline{x}_1}{s_1}+\gamma_2\frac{x_{i2}-\overline{x}_2}{s_2}+\cdots+\gamma_{p-1}\frac{x_{ip-1}-\overline{x}_{p-1}}{s_{p-1}}+\varepsilon_i \\ y=\gamma_0\mathbf{1}_n+\tilde{X}_s\gamma_I+\varepsilon,\quad\operatorname{E}(\varepsilon)=\mathbf{0},\quad\operatorname{Cov}(\varepsilon)=\sigma^2I_n \end{gather*}\]

为标准化线性回归模型(standardized linear regression model),其中\(\tilde{X}_s=\tilde{X}_c\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\)(请证明该结论)被称为标准化设计矩阵(standardized design matrix),第二行是第一行的矩阵表示。

Theorem 14.12. 对于线性回归模型,设\(\hat{\beta}=(\hat{\beta}_0,\hat{\beta}_1, \hat{\beta}_2, \dots, \hat{\beta}_{p-1})\)为正则方程的解,则有以下结论:

  1. \(X^{\top}X,\tilde{X}^{\top}\tilde{X},\tilde{X}_c^{\top}\tilde{X}_c\)和\(\tilde{X}_s^{\top}\tilde{X}_s\)都是正定阵,于是都可逆;

  2. \(\mathbf{1}_n^{\top}\tilde{X}_c=\mathbf{1}_n^{\top}\tilde{X}_s=\mathbf{0}\);

  3. \(\hat{\alpha}_0=\hat{\gamma}_0=\overline{y}=\hat{\beta}_0+\overline{x}^{\top}\hat{\beta}_I,\;\hat{\alpha}_I=(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\tilde{X}_c^{\top}y=\hat{\beta}_I,\;\hat{\gamma}_I=(\tilde{X}_s^{\top}\tilde{X}_s)^{-1}\tilde{X}_s^{\top}y=\operatorname{diag}\{s_1, s_2, \dots, s_{p-1}\}\hat{\alpha}_I(\hat{\beta}_I)\),即原经验回归方程、中心化后得到的经验回归方程与标准化后得到的经验回归方程是等价的,且有\(\tilde{X}_c\hat{\alpha}_I=\tilde{X}_s\hat{\gamma}_I\);

  4. \(\operatorname{SSE}=\operatorname{SSE}_c=\operatorname{SSE}_s,\;\operatorname{SSE}_c=(y-\overline{y})^{\top}(y-\overline{y})-\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y,\;\operatorname{SSE}_s=(y-\overline{y})^{\top}(y-\overline{y})-\hat{\gamma}_I^{\top}\tilde{X}_s^{\top}y\),即\(\hat{\sigma}^2=\hat{\sigma}_c^2=\hat{\sigma}_s^2\);

  5. \((n-1)R=\tilde{X}_s^{\top}\tilde{X}_s\),其中\(R\)为回归自变量之间的样本相关系数矩阵;

  6. \(\operatorname{Cov}(\hat{\beta})=\sigma^2(X^{\top}X)^{-1},\;\operatorname{Cov}(\hat{\beta}_I)=\operatorname{Cov}(\hat{\alpha}_I)\),且:

    \[\begin{equation*} \operatorname{Cov}(\hat{\alpha})=\sigma^2 \begin{pmatrix} \dfrac{1}{n} & \mathbf{0} \\ \mathbf{0} & (\tilde{X}_c^{\top}\tilde{X}_c)^{-1} \end{pmatrix},\quad \operatorname{Cov}(\hat{\gamma})=\sigma^2 \begin{pmatrix} \dfrac{1}{n} & \mathbf{0} \\ \mathbf{0} & (\tilde{X}_s^{\top}\tilde{X}_s)^{-1} \end{pmatrix} \end{equation*}\]

证明. (1)由定理 2.25可知\(X^{\top}X\)是一个半正定阵。若存在不为零向量的\(\alpha\)使得\(\alpha^{\top}X^{\top}X\alpha=0\),则有\(||X\alpha||=0\),即\(X\alpha=\mathbf{0}\)。而\(\operatorname{rank}(X)=p\),所以\(\alpha=\mathbf{0}\),矛盾,于是\(X^{\top}X\)是一个正定阵,由定理 2.17(6)可知它是可逆的。\(\tilde{X}^{\top}\tilde{X},\tilde{X}_c^{\top}\tilde{X}_c\)和\(\tilde{X}_s^{\top}\tilde{X}_s\)类似可得。

(2)由定义即可得到。

(3)由(1),对于中心化模型,此时的正则方程变为:

\[\begin{gather*} \begin{pmatrix} \mathbf{1}_n & \tilde{X}_c \\ \end{pmatrix}^{\top} \begin{pmatrix} \mathbf{1}_n & \tilde{X}_c \\ \end{pmatrix}\alpha= \begin{pmatrix} \mathbf{1}_n & \tilde{X}_c \\ \end{pmatrix}^{\top}y \\ \begin{pmatrix} \mathbf{1}_n^{\top} \\ \tilde{X}_c^{\top} \end{pmatrix} \begin{pmatrix} \mathbf{1}_n & \tilde{X}_c \\ \end{pmatrix}\alpha= \begin{pmatrix} \mathbf{1}_n & \tilde{X}_c \\ \end{pmatrix}^{\top}y \\ \begin{pmatrix} n & \mathbf{0} \\ \mathbf{0} & \tilde{X}_c^{\top}\tilde{X}_c \end{pmatrix}\alpha= \begin{pmatrix} \sum\limits_{i=1}^{n}y_i \\ \tilde{X}_c^{\top}y \end{pmatrix} \\ \begin{pmatrix} n\alpha_0 \\ \tilde{X}_c^{\top}\tilde{X}_c\alpha_I \end{pmatrix}= \begin{pmatrix} \sum\limits_{i=1}^{n}y_i \\ \tilde{X}_c^{\top}y \end{pmatrix} \end{gather*}\]

也即:

\[\begin{equation*} \hat{\alpha}_0=\overline{y},\quad\hat{\alpha}_I=(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\tilde{X}_c^{\top}y \end{equation*}\]

同理可得:

\[\begin{equation*} \hat{\gamma}_0=\overline{y},\quad\hat{\gamma}_I=(\tilde{X}_s^{\top}\tilde{X}_s)^{-1}\tilde{X}_s^{\top}y \end{equation*}\]

由前述和性质 2.1.2(4)可得:

\[\begin{align*} &\tilde{X}_c^{\top}\tilde{X}_c=\tilde{X}^{\top}\left(I_n-\dfrac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\right)^{\top}\tilde{X}_c=\tilde{X}^{\top}\left(I_n-\dfrac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\right)\tilde{X}_c \\ =&\tilde{X}^{\top}\tilde{X}_c-\tilde{X}^{\top}\frac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\tilde{X}_c=\tilde{X}^{\top}\tilde{X}_c=\tilde{X}^{\top}\left(I_n-\dfrac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\right)\tilde{X} \\ =&\tilde{X}^{\top}\tilde{X}-\dfrac{1}{n}\tilde{X}^{\top}\mathbf{1}_n\mathbf{1}_n^{\top}\tilde{X}=\tilde{X}^{\top}\tilde{X}-\dfrac{1}{n}n\overline{x}n\overline{x}^{\top}=\tilde{X}^{\top}\tilde{X}-n\overline{x}\overline{x}^{\top} \end{align*}\]

于是根据性质 2.1.10(17)可得:

\[\begin{align*} &\hat{\beta}=(X^{\top}X)^{-1}X^{\top}y= \begin{pmatrix} n & \mathbf{1}_{n}^{\top}\tilde{X} \\ \tilde{X}^{\top}\mathbf{1}_n & \tilde{X}^{\top}\tilde{X} \end{pmatrix}^{-1} \begin{pmatrix} \mathbf{1}_n^{\top}y \\ \tilde{X}^{\top}y \end{pmatrix} \\ =& \begin{pmatrix} \dfrac{1}{n}+\dfrac{1}{n}\mathbf{1}_{n}^{\top}\tilde{X}( \tilde{X}^{\top}\tilde{X}-\tilde{X}^{\top}\mathbf{1}_n\dfrac{1}{n}\mathbf{1}_{n}^{\top}\tilde{X})^{-1}\tilde{X}^{\top}\mathbf{1}_n\dfrac{1}{n} & -\dfrac{1}{n}\mathbf{1}_{n}^{\top}\tilde{X}(\tilde{X}^{\top}\tilde{X}-\tilde{X}^{\top}\mathbf{1}_n\dfrac{1}{n}\mathbf{1}_{n}^{\top}\tilde{X})^{-1} \\ -(\tilde{X}^{\top}\tilde{X}-\tilde{X}^{\top}\mathbf{1}_n\dfrac{1}{n}\mathbf{1}_{n}^{\top}\tilde{X})^{-1}\tilde{X}^{\top}\mathbf{1}_n\dfrac{1}{n} & (\tilde{X}^{\top}\tilde{X}-\tilde{X}^{\top}\mathbf{1}_n\dfrac{1}{n}\mathbf{1}_{n}^{\top}\tilde{X})^{-1} \end{pmatrix} \begin{pmatrix} \mathbf{1}_n^{\top}y \\ \tilde{X}^{\top}y \end{pmatrix} \\ =& \begin{pmatrix} \dfrac{1}{n}+\overline{x}^{\top}(\tilde{X}^{\top}\tilde{X}-\overline{x}n\overline{x}^{\top})^{-1}\overline{x} & -\overline{x}^{\top}(\tilde{X}^{\top}\tilde{X}-\overline{x}n\overline{x}^{\top})^{-1} \\ -(\tilde{X}^{\top}\tilde{X}-\overline{x}n\overline{x}^{\top})^{-1}\overline{x} & (\tilde{X}^{\top}\tilde{X}-\overline{x}n\overline{x}^{\top})^{-1} \end{pmatrix} \begin{pmatrix} \mathbf{1}_n^{\top}y \\ \tilde{X}^{\top}y \end{pmatrix} \\ =& \begin{pmatrix} \dfrac{1}{n}+\overline{x}^{\top}(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\overline{x} & -\overline{x}^{\top}(\tilde{X}_c^{\top}\tilde{X}_c)^{-1} \\ -(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\overline{x} & (\tilde{X}_c^{\top}\tilde{X}_c)^{-1} \end{pmatrix} \begin{pmatrix} \mathbf{1}_n^{\top}y \\ \tilde{X}^{\top}y \end{pmatrix} \\ =& \begin{pmatrix} \overline{y}+\overline{x}^{\top}(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\overline{x}\mathbf{1}_n^{\top}y-\overline{x}^{\top}(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\tilde{X}^{\top}y \\ -(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\overline{x}\mathbf{1}_n^{\top}y+(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\tilde{X}^{\top}y \end{pmatrix} \\ =& \begin{pmatrix} \overline{y}+\overline{x}^{\top}(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}(\overline{x}\mathbf{1}_n^{\top}-\tilde{X}^{\top})y \\ (\tilde{X}_c^{\top}\tilde{X}_c)^{-1}(\tilde{X}^{\top}-\overline{x}\mathbf{1}_n^{\top})y \end{pmatrix}= \begin{pmatrix} \overline{y}-\overline{x}^{\top}(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\tilde{X}_c^{\top}y \\ (\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\tilde{X}_c^{\top}y \end{pmatrix} \end{align*}\]

所以有:

\[\begin{equation*} \hat{\beta}_I=\hat{\alpha}_I,\quad\hat{\beta}_0=\overline{y}-\overline{x}^{\top}\hat{\beta}_I \end{equation*}\]

由前述、性质 2.1.2(4)和性质 2.1.10(11)可得:

\[\begin{align*} \hat{\gamma}_I&=\left[\left(\tilde{X}_c\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\right)^{\top}\tilde{X}_c\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\right]^{-1} \\ &\quad\cdot\left(\tilde{X}_c\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\right)^{\top}y \\ &=\left(\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\tilde{X}_c^{\top}\tilde{X}_c\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\right)^{-1} \\ &\quad\cdot\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\tilde{X}_c^{\top}y \\ =&\operatorname{diag}\{s_1, s_2, \dots, s_{p-1}\}(\tilde{X}_c^{\top}\tilde{X}_c)^{-1}\operatorname{diag}\{s_1, s_2, \dots, s_{p-1}\}\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\tilde{X}_c^{\top}y \\ =&\operatorname{diag}\{s_1, s_2, \dots, s_{p-1}\}\hat{\alpha}_I \end{align*}\]

将上述结果代入经验回归方程即可得到三种方程的等价性,同时:

\[\begin{equation*} \tilde{X}_s\hat{\gamma}_I=\tilde{X}_c\operatorname{diag}\left\{\dfrac{1}{s_1},\dfrac{1}{s_2},\dots,\dfrac{1}{s_{p-1}}\right\}\operatorname{diag}\{s_1, s_2, \dots, s_{p-1}\}\hat{\alpha}_I=\tilde{X}_c\hat{\alpha}_I \end{equation*}\]

(4)根据(3)可得:

\[\begin{gather*} \begin{aligned} &\operatorname{SSE}_c=||y-\hat{\alpha}_0\mathbf{1}_n-\tilde{X}_c\hat{\alpha}_I||^2=||y-\hat{\beta}_0\mathbf{1}_n-\overline{x}^{\top}\hat{\beta}_I\mathbf{1}_n-\tilde{X}_c\hat{\beta}_I||^2 \\ =&||y-\hat{\beta}_0\mathbf{1}_n-\mathbf{1}_n\overline{x}^{\top}\hat{\beta}_I-\tilde{X}_c\hat{\beta}_I||^2=||y-\hat{\beta}_0\mathbf{1}_n-\tilde{X}\hat{\beta}_I||^2=||y-X\hat{\beta}||^2=\operatorname{SSE} \end{aligned} \\ \operatorname{SSE}_s=||y-\hat{\gamma}_0\mathbf{1}_n-\tilde{X}_s\hat{\gamma}_I||^2=||y-\hat{\alpha}_0\mathbf{1}_n-\tilde{X}_c\hat{\alpha}_I||^2=\operatorname{SSE}_c \end{gather*}\]

于是\(\operatorname{SSE}=\operatorname{SSE}_c=\operatorname{SSE}_s\),类似定理 14.5可得中间两式,由定理 14.2可知后式成立。

(5)注意到:

\[\begin{align*} &\left(\frac{x_{1i}-\overline{x}_i}{s_i},\frac{x_{2i}-\overline{x}_i}{s_i},\dots,\frac{x_{ni}-\overline{x}_i}{s_i}\right)^{\top}\left(\frac{x_{1j}-\overline{x}_j}{s_j},\frac{x_{2j}-\overline{x}_j}{s_j},\dots,\frac{x_{nj}-\overline{x}_j}{s_j}\right) \\ =&\frac{1}{s_is_j}\sum_{k=1}^{n}(x_{ki}-\overline{x}_i)(x_{kj}-\overline{x}_j)=\frac{n-1}{s_is_j}\frac{1}{n-1}\sum_{k=1}^{n}(x_{ki}-\overline{x}_i)(x_{kj}-\overline{x}_j) \\ =&(n-1)\widehat{\operatorname{Corr}}(\tilde{X})(i;j) \end{align*}\]

(6)由性质 14.1.1(5)和性质 6.4.3(3)可知\(I_p\operatorname{Cov}(\hat{\beta})I_p=\sigma^2(X^{\top}X)^{-1}\),即\(\operatorname{Cov}(\hat{\beta})=\sigma^2(X^{\top}X)^{-1}\)。第二式由(3)第二式即可得到。后两式由对应的正则方程和性质 6.4.3(3)即可得到。 ◻

note 14.6. 由上述定理第三条又可以看出中心化和标准化能够使得常数项与回归系数的估计被分开,常数项的估计值直接就等于\(y\)的均值,并且由上述定理第六条可知对于中心化或标准化模型,常数项与回归系数的估计是不相关的,于是在理论分析中我们可以只关注回归系数的估计。标准化模型的另一个优势是可以消除变量量纲的影响,使得回归系数的估计可直接反应各自变量对因变量预测的重要程度。

14.5.1 显著性检验与复相关系数

14.5.1.1 显著性检验

Definition 14.18. 对于定义 14.16,称假设检验:

\[\begin{equation*} H_0:\beta_1=\beta_2=\cdots=\beta_{p-1}=0,\quad H_1:\text{至少有一个回归系数不为}0 \end{equation*}\]

为回归方程的显著性检验。称:

\[\begin{equation*} H_0:\beta_i=0,\quad H_1:\beta_i\ne0 \end{equation*}\]

为回归系数\(\beta_i\)的显著性检验。

Theorem 14.13. 对于定义 14.16,回归方程的显著性检验的统计量和拒绝域为:

\[\begin{gather*} F=\frac{\hat{\beta}_I^{\top}\tilde{X}^{\top}\left(I_n-\frac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\right)y/(p-1)}{\operatorname{SSE}/(n-p)},\quad \{F:F>\operatorname{F}_{p-1,n-p}(1-\alpha)\} \\ F=\frac{\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y/(p-1)}{\operatorname{SSE}_c/(n-p)},\quad \{F:F>\operatorname{F}_{p-1,n-p}(1-\alpha)\} \\ F=\frac{\hat{\gamma}_I^{\top}\tilde{X}_s^{\top}y/(p-1)}{\operatorname{SSE}_s/(n-p)},\quad \{F:F>\operatorname{F}_{p-1,n-p}(1-\alpha)\} \end{gather*}\]

回归系数\(\beta_i\)的显著性检验的统计量和拒绝域为:

\[\begin{gather*} t=\frac{\hat{\beta}_i}{\sqrt{c_{ii}}\hat{\sigma}},\quad\left\{t:|t|>\operatorname{t}_{n-p}\left(1-\frac{\alpha}{2}\right)\right\} \end{gather*}\]

其中\((X^{\top}X)^{-1}=(c_{ij})\),另外两种情况下的统计量和拒绝域与上式类似。

证明. (1)可以发现此时的假设检验即为在定理 14.7中取\(A=(\mathbf{0},I_{p-1}),\;b=\mathbf{0}\)时的情况。原假设下模型变为:

\[\begin{equation*} y_i=\alpha_0+\varepsilon_i,\quad i=1,2,\dots,n \end{equation*}\]

此时设计阵为\(\mathbf{1}_n\),正则方程为\(n\hat{\alpha}_0=n\overline{y}\),\(\hat{\alpha}=\overline{y}\),由定理 14.5可得\(\operatorname{SSE}_A=y^{\top}y-\overline{y}\mathbf{1}_n^{\top}y=y^{\top}y-\overline{y}n\overline{y}=y^{\top}y-n\overline{y}^2\)。备择假设下根据定理 14.12(3)可得:

\[\begin{equation*} \operatorname{SSE}_c=y^{\top}y-\hat{\alpha}^{\top}X_c^{\top}y=y^{\top}y-\hat{\alpha}_0n\overline{y}-\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y=y^{\top}y-n\overline{y}^2-\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y \end{equation*}\]

于是有:

\[\begin{equation*} \operatorname{SSE}_A-\operatorname{SSE}_c=y^{\top}y-n\overline{y}^2-(y^{\top}y-n\overline{y}^2-\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y)=\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y \end{equation*}\]

由定理 14.7(5)即可得出第二式。由\(\tilde{X}_c=\left(I_n-\dfrac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\right)\tilde{X}\)和定理 14.12(3)(4)即可得剩下两式。

(2)仿照性质 14.2.1(2)的证明过程可知:

\[\begin{equation*} \hat{\beta}\sim\operatorname{N}_p[\beta,\sigma^2(X^{\top}X)^{-1}] \end{equation*}\]

记\((X^{\top}X)^{-1}=(c_{ij})\),由性质 6.5.8(3)可得:

\[\begin{equation*} \hat{\beta}_i\sim\operatorname{N}(\beta_i,\sigma^2c_{ii}) \end{equation*}\]

所以当\(H_0\)成立时有:

\[\begin{equation*} \frac{\hat{\beta}_i}{\sigma\sqrt{c_{ii}}}\sim\operatorname{N}(0,1) \end{equation*}\]

由性质 14.2.1(2)可知:

\[\begin{equation*} \frac{(n-p)\hat{\sigma}^2}{\sigma^2}\sim\chi_{n-p}^2 \end{equation*}\]

所以:

\[\begin{equation*} \frac{\hat{\beta}_i}{\sigma\sqrt{c_{ii}}}\Big/\sqrt{\frac{(n-p)\hat{\sigma}^2}{\sigma^2(n-p)}}=\frac{\hat{\beta}_i}{\sqrt{c_{ii}}\hat{\sigma}}\sim t_{n-p} \end{equation*}\]

◻

14.5.1.2 复相关系数

note 14.7. 复相关系数度量的是回归自变量和因变量之间的最大相关系数以后给出证明并联系多元统计中的典型相关分析,修改前述复相关系数的叙述与此处的叙述,由前述,当选用中心化模型或者标准化模型后我们可以把常数项剥离出去,这样就可以只剩下因变量与回归自变量了。由性质 2.1.5(4)和定理 14.12(3)可知此时的回归平方和应该修改为:

\[\begin{equation*} \operatorname{RSS}(\beta)=\hat{\beta}_I^{\top}\tilde{X}^{\top}(y-\overline{y})=\hat{\beta}_I^{\top}\tilde{X}^{\top}\left(I_n-\frac{1}{n}\mathbf{1}_n\mathbf{1}_n^{\top}\right)y=\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y=\hat{\gamma}_I^{\top}\tilde{X}_s^{\top}y \end{equation*}\]

总平方和为:

\[\begin{equation*} \operatorname{RSS}_{\text{总}}=(y-\overline{y})^{\top}(y-\overline{y}) \end{equation*}\]

由性质 2.1.5(4)和定理 14.12(3)可得线性回归模型的复相关系数公式为:

\[\begin{equation*} R^2=\frac{\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y}{(y-\overline{y})^{\top}(y-\overline{y})}=\frac{\hat{\gamma}_I^{\top}\tilde{X}_s^{\top}y}{(y-\overline{y})^{\top}(y-\overline{y})} \end{equation*}\]

补充调整后\(R^2\)

Theorem 14.14. 对于定义 14.17,回归方程的显著性检验的统计量\(F\)与复相关系数\(R^2\)有如下关系:

\[\begin{equation*} F=\frac{R^2}{1-R^2}\frac{n-p}{p-1} \end{equation*}\]

证明. 由定理 14.13(1)中\(\operatorname{SSE}_c\)的公式可得:

\[\begin{align*} F&=\frac{\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y/(p-1)}{\operatorname{SSE}_c/(n-p)}=\frac{\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y/[\operatorname{RSS}_{\text{总}}(p-1)]}{[(y-\overline{y})^{\top}(y-\overline{y})-\hat{\alpha}_I^{\top}\tilde{X}_c^{\top}y]/[\operatorname{RSS}_{\text{总}}(n-p)]} \\ &=\frac{R^2/(p-1)}{(1-R^2)/(n-p)}=\frac{R^2}{1-R^2}\frac{n-p}{p-1} \end{align*}\]

类似可得标准化模型时的结果。 ◻

14.5.2 模型选择

Theorem 14.15. 当全模型正确时:

  1. 剔除一部分自变量后,可使得剩余的那部分自变量的回归系数的LSE的方差减小,但此时的估计一般为有偏估计。若被剔除的自变量对因变量影响较小,则可使得剩余的那部分自变量的回归系数的LSE的MSE减小;

  2. 若用选模型作预测,预测一般是有偏的,但预测偏差的方差减小。若被剔除的自变量对因变量影响较小,则可使得预测的MSE减小。

14.5.2.1 RMSq准则

14.5.2.2 Cp准则

14.5.2.3 AIC准则

14.5.2.4 模型选择方法

Method 14.1. (Best subset selection)

对所有可能的自变量组合拟合线性回归模型并选定一个模型指标,选择指标最优的变量组合。

Method 14.2. (Forward Selection)

从不包含任何自变量的模型开始,选择与因变量相关系数的绝对值最大且引入模型后能够通过回归系数的显著性检验的自变量,将之添加入模型中,迭代至终止条件,如达到最大自变量个数或没有自变量能够通过回归系数的显著性检验等。

Method 14.3. (Backward Selection)

从全模型开始,选择回归系数的显著性检验中\(t\)统计量绝对值最小的变量,若它显著,则终止,认为最优模型为全模型;若它不显著,则删除该变量。迭代至终止条件,如达到最小自变量个数或所有剩余的自变量都能够通过回归系数的显著性检验。

Method 14.4. (Stepwise)

从不包含任何自变量的模型开始,选择与因变量相关系数的绝对值最大且引入模型后能够通过回归系数的显著性检验的自变量,将之添加入模型中。在剩余自变量中选择与因变量相关系数的绝对值最大且引入模型后能够通过回归系数的显著性检验的自变量,将之添加入模型中。对这两个自变量进行回归系数的显著性检验,删除不显著的变量,再从排除这两个自变量后剩余的自变量中按照前述规则添加一个自变量,然后按照前述规则删除相应的变量。迭代至终止条件。

14.5.3 回归诊断

14.5.3.1 残差分析

Definition 14.19. 称以某种残差为纵坐标、其它量为横坐标的散点图为残差图(residual plot)。

Definition 14.20. 当模型为定义 14.16时,将:

\[\begin{equation*} r_i=\frac{\hat{\varepsilon}_i}{\sqrt{\hat{\sigma}^2(1-p_{ii})}} \end{equation*}\]

称为学生化残差(studentized residual)。由性质 14.1.2(1)可知它相当于是对\(\hat{\varepsilon}\)进行标准化然后用\(\sigma^2\)的估计\(\hat{\sigma}^2\)进行替换后得到的值。

note 14.8. 应用上可以近似地认为\(r_i\)相互独立且服从\(\operatorname{N}(0,1)\)。若将\(\hat{\varepsilon}\)与\(\hat{y}\)画作二维散点图,以\(\hat{y}\)为横坐标、\(r_i\)为纵坐标,点的纵坐标应大致分布于\([-2,2]\),且由性质 14.1.2(3)和性质 6.5.8(2)(8)可得这些点不应呈现出任何趋势(\(\hat{y}\)与\(\hat{\varepsilon}_i\)独立)。若不满足上述现象,则此时模型有问题,可能是漏掉了重要的回归自变量,也可能是数据不满足定义 14.16中的假设。在数据不满足定义 14.16中的假设时,一个解决方案是对\(y\)实施变换,使得变换后得到的向量与回归自变量之间存在线性相关关系,同时让误差也符合假设,一个在\(y\)值全部为正数时使用广泛的变换就是下述的Box-Cox变换。

14.5.3.2 Box-Cox变换

Definition 14.21. Box-Cox变换是对各分量都为正数的\(y\)进行如下变换:

\[\begin{equation*} y_i^{(\lambda)}= \begin{cases} \dfrac{y_i^{\lambda}-1}{\lambda},&\lambda\ne0 \\ \ln y_i,&\lambda=0 \end{cases} \end{equation*}\]

其中\(\lambda\)是一个待定的变换参数。

note 14.9. 可以看出Box-Cox变换是一个变换族,包括了对数变换、平方根变换和倒数变换等。确定\(\lambda\)的值的方式为极大似然估计法,选择\(\lambda\)值使得\(y^{(\lambda)}\sim\operatorname{N}(X\beta,\sigma^2I_n)\)最有可能发生,这一方法的选择是很直观的。实际操作时若\(y\)有分量非正,可通过平移将其变换为全部为正值的情况,然后再进行Box-Cox变换。下面解释实际计算。

对于固定的\(\lambda\),\(\beta\)和\(\sigma^2\)的似然函数为:

\[\begin{equation*} L(\beta,\sigma^2,\lambda)=\frac{1}{(2\pi)^{\frac{n}{2}}(\sigma^2)^\frac{n}{2}}\exp\left(-\frac{1}{2\sigma^2}||y^{(\lambda)}-X\beta||^2\right)|\mathbf{J}| \end{equation*}\]

\(\mathbf{J}\)为变换的Jacobi行列式:

\[\begin{equation*} \mathbf{J}=\left|\frac{\mathop{}\!\mathrm{d}y_i^{(\lambda)}}{\mathop{}\!\mathrm{d}y_i}\right|=\prod_{i=1}^{n}y_i^{\lambda-1} \end{equation*}\]

由性质 14.2.1(1)可知此时\(\beta\)和\(\sigma^2\)的极大似然估计为:

\[\begin{equation*} \hat{\beta}(\lambda)=(X^{\top}X)^{-1}X^{\top}y^{(\lambda)},\quad\hat{\sigma}^2(\lambda)=\frac{1}{n}\operatorname{SSE}(\lambda) \end{equation*}\]

对应的对数似然函数最大值为:

\[\begin{equation*} \ln L_{\text{max}}(\lambda)=-\frac{n}{2}\ln2\pi-\frac{n}{2}\ln\frac{\operatorname{SSE}(\lambda)}{n}-\frac{1}{2}\frac{n}{\operatorname{SSE}(\lambda)}\operatorname{SSE}(\lambda)+\ln\mathbf{J} \end{equation*}\]

由性质 14.1.2(2)可知略去与\(\lambda\)无关的项之后的对数似然函数最大值为:

\[\begin{align*} \ln L_{\text{max}}(\lambda)&=-\frac{n}{2}\ln \operatorname{SSE}(\lambda)+\sum_{i=1}^{n}\ln y_i^{\lambda-1}=-\frac{n}{2}\ln\{[y^{(\lambda)}]^{\top}(I_n-P_X)y^{(\lambda)}\}+\frac{n}{2}\ln\mathbf{J}^{\frac{2}{n}} \\ &=-\frac{n}{2}\ln\left\{\frac{[y^{(\lambda)}]^{\top}}{\mathbf{J}^{\frac{1}{n}}}(I_n-P_X)\frac{y^{(\lambda)}}{\mathbf{J}^{\frac{1}{n}}}\right\} \end{align*}\]

可以看出\(-\dfrac{n}{2}\)也可略去,因为对数函数是单调函数,所以它也可以略去,于是只需解:

\[\begin{equation*} \lambda=\underset{\lambda}{\arg\min}\frac{[y^{(\lambda)}]^{\top}}{\mathbf{J}^{\frac{1}{n}}}(I_n-P_X)\frac{y^{(\lambda)}}{\mathbf{J}^{\frac{1}{n}}} \end{equation*}\]

记\(z^{(\lambda)}=\dfrac{y^{(\lambda)}}{\mathbf{J}^{\frac{1}{n}}}\),则:

\[\begin{equation*} z_i^{(\lambda)}= \begin{cases} \dfrac{y_i^{\lambda}-1}{\lambda\left(\prod\limits_{i=1}^{n}y_i\right)^{\frac{\lambda-1}{n}}},&\lambda\ne0 \\ \dfrac{\ln y_i}{\left(\prod\limits_{i=1}^{n}y_i\right)^{\frac{\lambda-1}{n}}},&\lambda=0 \end{cases} \end{equation*}\]

\(\lambda\)的解析表达式一般来讲很难得到,但我们可以求解数值解,即对不同的\(\lambda\)计算\(z^{(\lambda)}\)和\(I_n-P_X\)。为了便于计算机计算,可预先计算的量为:

\[\begin{equation*} I_n-P_X,\quad\sqrt[n]{\prod\limits_{i=1}^{n}y_i} \end{equation*}\]

Algorithm 14.1 Box-Cox 变换的计算机求解

Input: 观测向量 \(y = (y_1,\dots,y_n)^{\top}\),设计矩阵 \(X\),候选参数集合 \(\Lambda\)

Output: 最优参数 \(\hat{\lambda}\)和变换后的向量\(y^{(\lambda)}\)

预处理: 若存在 \(y_i \le 0\),则对 \(y\) 作平移: \(y \gets y + c\),其中 \(c > -\min(y_i)\)

计算预备量:

) \(I_n - P_X\)

) 几何平均数 \(g = \sqrt[n]{\prod\limits_{i=1}^n y_i}\)

for \(\lambda \in \Lambda\) do

if \(\lambda \ne 0\) then

计算变换向量\(z^{(\lambda)}\),其中:

\[\begin{equation*} z_i^{(\lambda)}=\dfrac{y_i^\lambda-1}{\lambda g^{\lambda-1}},\;i=1,2,\dots,n \end{equation*}\]

else

计算变换向量\(z^{(\lambda)}\),其中:

\[\begin{equation*} z_i^{(\lambda)}=\dfrac{\ln y_i}{g^{\lambda-1}},\;i=1,2,\dots,n \end{equation*}\]

end if

计算误差平方和:

\[ \operatorname{SSE}(\lambda) = [z^{(\lambda)}]^{\top} (I_n - P_X) z^{(\lambda)} \]

end for

选择最优参数:

\[ \hat{\lambda} = \underset{\lambda \in \Lambda}{\arg\min}\operatorname{SSE}(\lambda) \]

return \(\hat{\lambda}, \; y^{(\hat{\lambda})}\)

14.5.3.3 影响分析

影响分析即为探查对估计或预测有较大影响的数据。

Definition 14.22. 定义第\(i\)个样本Cook统计量为:

\[\begin{equation*} D_i=\frac{(\hat{\beta}-\hat{\beta}_{(i)})^{\top}X^{\top}X(\hat{\beta}-\hat{\beta}_{(i)})}{p\hat{\sigma}^2},\quad i=1,2,\dots,n \end{equation*}\]

其中\(\hat{\beta}_{(i)}\)表示删除第\(i\)个样本后拟合得到的回归系数。

note 14.10. 从定理 14.8可以看出:

\[\begin{equation*} \left\{\beta:\frac{(\hat{\beta}-\beta)X^{\top}X(\hat{\beta}-\beta)}{p\hat{\sigma}^2}\leqslant\operatorname{F}_{p,n-p}(\alpha)\right\} \end{equation*}\]

是拒绝假设\(\beta_0=\beta_1=\cdots=\beta_{p-1}=0\)后\(\beta\)置信水平为\(1-\alpha\)的置信椭球。当\(\beta\)被换为\(\hat{\beta}_{(i)}\)时,\(D_i\)的值就对应着\(\hat{\beta}_{(i)}\)在\(\hat{\beta}\)置信椭球上的置信水平,\(D_i\)的值越大,\(\alpha\)就越大,置信水平就越小,也就是说\(D_i\)越大\(\hat{\beta}_{(i)}\)对应在\(\hat{\beta}\)的置信水平越小的置信椭球,加入第\(i\)个样本后得到的\(\hat{\beta}\)对应的置信水平越大,这往往代表着\(\hat{\beta}\)离样本中心越远(置信水平越大往往置信域越大,而置信域中心的点一般是均值的估计),即第\(i\)个样本对估计或预测造成的影响越大。

上述公式的一个问题是需要计算\(n+1\)次回归的结果,下面的结论给出了一个非常便捷的Cook统计量的计算公式。

Theorem 14.16. \(D_i\)有如下计算公式:

\[\begin{equation*} D_i=\frac{1}{p}\left(\frac{p_{ii}}{1-p_{ii}}\right)r_i^2,\quad i=1,2,\dots,n \end{equation*}\]

其中\(r_i\)是学生化残差,\(p_{ii}\)是矩阵\(P_X\)的第\(i\)个主对角元。

证明. 注意到恒等式(两边同乘\(A-uv^{\top}\)即可):

\[\begin{equation*} (A-uv^{\top})^{-1}=A^{-1}+\frac{A^{-1}uv^{\top}A^{-1}}{1-u^{\top}A^{-1}v} \end{equation*}\]

其中\(A\in M_{n}(K)\)且可逆,\(u,v\in M_{n\times 1}(K)\)。记\(X_{(i)}\)为去除第\(i\)个样本后的设计阵,\(x_i^{\top}\)为\(X\)的第\(i\)行,由性质 2.1.1(1)的第四种理解可得:

\[\begin{equation*} (X_{(i)}^{\top}X_{(i)})^{-1}=(X^{\top}X-x_ix_i^{\top})^{-1}=(X^{\top}X)^{-1}+\frac{(X^{\top}X)^{-1}x_ix_i^{\top}(X^{\top}X)^{-1}}{1-p_{ii}} \end{equation*}\]

将上式两边同乘\(X^{\top}y\),记\(y_{(i)}\)为\(y\)去掉第\(i\)个分量后的向量,利用\(X^{\top}y=X_{(i)}^{\top}y_{(i)}+y_ix_i\)可得:

\[\begin{gather*} (X_{(i)}^{\top}X_{(i)})^{-1}X^{\top}y=(X^{\top}X)^{-1}X^{\top}y+\frac{(X^{\top}X)^{-1}x_ix_i^{\top}(X^{\top}X)^{-1}X^{\top}y}{1-p_{ii}} \\ (X_{(i)}^{\top}X_{(i)})^{-1}X_{(i)}^{\top}y_{(i)}+(X_{(i)}^{\top}X_{(i)})^{-1}y_ix_i=\hat{\beta}+\frac{(X^{\top}X)^{-1}x_ix_i^{\top}\hat{\beta}}{1-p_{ii}} \\ \hat{\beta}_{(i)}+(X_{(i)}^{\top}X_{(i)})^{-1}y_ix_i=\hat{\beta}+\frac{(X^{\top}X)^{-1}x_ix_i^{\top}\hat{\beta}}{1-p_{ii}} \end{gather*}\]

再将原式两边同乘\(x_i\)可得:

\[\begin{align*} &(X_{(i)}^{\top}X_{(i)})^{-1}x_i=(X^{\top}X)^{-1}x_i+\frac{(X^{\top}X)^{-1}x_ix_i^{\top}(X^{\top}X)^{-1}x_i}{1-p_{ii}} \\ =&\frac{(1-p_{ii})(X^{\top}X)^{-1}x_i+(X^{\top}X)^{-1}x_ix_i^{\top}(X^{\top}X)^{-1}x_i}{1-p_{ii}} \\ =&\frac{[1-x_i^{\top}(X^{\top}X)^{-1}x_i](X^{\top}X)^{-1}x_i+(X^{\top}X)^{-1}x_ix_i^{\top}(X^{\top}X)^{-1}x_i}{1-p_{ii}} \\ =&\frac{(X^{\top}X)^{-1}x_i-x_i^{\top}(X^{\top}X)^{-1}x_i(X^{\top}X)^{-1}x_i+(X^{\top}X)^{-1}x_ix_i^{\top}(X^{\top}X)^{-1}x_i}{1-p_{ii}}=\frac{(X^{\top}X)^{-1}x_i}{1-p_{ii}} \end{align*}\]

代入到上一组公式中可得:

\[\begin{gather*} \hat{\beta}_{(i)}+\frac{(X^{\top}X)^{-1}x_iy_i}{1-p_{ii}}=\hat{\beta}+\frac{(X^{\top}X)^{-1}x_ix_i^{\top}\hat{\beta}}{1-p_{ii}} \\ \hat{\beta}_{(i)}+\frac{(X^{\top}X)^{-1}x_iy_i}{1-p_{ii}}=\hat{\beta}+\frac{(X^{\top}X)^{-1}x_i\hat{y}_i}{1-p_{ii}} \\ \hat{\beta}-\hat{\beta}_{(i)}=\frac{(X^{\top}X)^{-1}x_i(y_i-\hat{y}_i)}{1-p_{ii}}=\frac{(X^{\top}X)^{-1}x_i\hat{\varepsilon}_i}{1-p_{ii}} \end{gather*}\]

将上式代入到Cook统计量的定义中,由性质 2.1.2(4)和性质 2.1.10(12)可得到:

\[\begin{align*} &D_i=\left[\frac{(X^{\top}X)^{-1}x_i\hat{\varepsilon}_i}{1-p_{ii}}\right]^{\top}(X^{\top}X)\left[\frac{(X^{\top}X)x_i\hat{\varepsilon}_i}{1-p_{ii}}\right]\frac{1}{p\hat{\sigma}^2} \\ =&\frac{1}{p}\frac{x_i^{\top}(X^{\top}X)^{-1}X^{\top}X(X^{\top}X)^{-1}x_i}{1-p_{ii}}\frac{\hat{\varepsilon}_i^2}{\hat{\sigma}^2(1-p_{ii})} \\ =&\frac{1}{p}\frac{x_i^{\top}(X^{\top}X)^{-1}x_i}{1-p_{ii}}r_i^2=\frac{1}{p}\frac{p_{ii}}{1-p_{ii}}r_i^2 \end{align*}\]

◻

14.5.3.4 异常点检测

note 14.11. 异常点检测即检测数据中是否存在某一个点不符合该组数据的模式,直观上来想一个残差值或学生化残差值较大的点是一个异常点,从建模的角度来看,异常点的特征构成不同于其它点,由此我们引入下述的均值漂移线性回归模型。判断一个点是不是异常点应是一个假设检验问题,我们需要找到一种方法来进行这种检验。我们只讨论数据中最多仅有一个异常点的情况,由于异常点会使得回归方程变形,所以多个异常点的识别是一个很复杂的问题。

Definition 14.23. 称:

\[\begin{equation*} y=(X,d_j)(\beta^{\top},\eta)^{\top},\quad\varepsilon\sim\operatorname{N}_n(\mathbf{0},\sigma^2I_n) \end{equation*}\]

为均值漂移线性回归模型(mean shift linear regression model),其中\(d_j\)为第\(j\)个分量为\(1\)其余分量为\(0\)的\(n\)维向量,\((X,d_j)\)列满秩。

Theorem 14.17. 对于定义 14.23,有:

  1. \(\beta\)的LSE\(\beta^{\star}\)和\(\eta\)的LSE\(\eta^{\star}\)分别为:

    \[\begin{equation*} \beta^{\star}=\hat{\beta}_{(j)},\quad\eta^{\star}=\frac{\hat{\varepsilon}_j}{1-p_{jj}} \end{equation*}\]

    \(\hat{\beta}_{(j)}\)为定义 14.15去除第\(j\)组数据后得到的\(\beta\)的LSE,\(p_{ii}\)是矩阵\(P_X\)的第\(i\)个主对角元。;

  2. 对于假设检验问题\(H_0:\eta=0,\;H_1:\eta\ne0\),检验统计量和拒绝域为:

    \[\begin{equation*} F=\frac{(n-p-1)r_j^2}{n-p-r_j^2},\quad\{F;F>\operatorname{F}_{1,n-p-1}(1-\alpha)\} \end{equation*}\]

    或:

    \[\begin{equation*} t=\left[\frac{(n-p-1)r_j^2}{n-p-r_j^2}\right]^{\frac{1}{2}},\quad\{t:|t|>\operatorname{t}_{n-p-1}\left(1-\frac{\alpha}{2}\right)\} \end{equation*}\]

    其中\(r_i\)是学生化残差。

证明. (1)由定理 14.12(1)可知\((X,d_j)^{\top}(X,d_j)\)可逆,于是此时的正则方程变为:

\[\begin{equation*} \begin{pmatrix} \beta^{\star} \\ \eta^{\star} \end{pmatrix}=[(X,d_j)^{\top}(X,d_j)]^{-1}(X,d_j)^{\top}y= \begin{pmatrix} X^{\top}X & x_j \\ x_j^{\top} & 1 \end{pmatrix}^{-1} \begin{pmatrix} X^{\top}y \\ y_j \end{pmatrix} \end{equation*}\]

由定理 14.12(1)可知\(X^{\top}X\)可逆,设\(x_j^{\top}\)为\(X\)的第\(j\)行,于是根据性质 2.1.10(17)可得:

\[\begin{align*} &\begin{pmatrix} \beta^{\star} \\ \eta^{\star} \end{pmatrix} \\ =&\begin{pmatrix} (X^{\top}X)^{-1}+(X^{\top}X)^{-1}x_j[1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1}x_j^{\top}(X^{\top}X)^{-1} & -(X^{\top}X)^{-1}x_j[1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1} \\ -[1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1}x_j^{\top}(X^{\top}X)^{-1} & [1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1} \end{pmatrix} \begin{pmatrix} X^{\top}y \\ y_j \end{pmatrix} \\ =& \begin{pmatrix} (X^{\top}X)^{-1}X^{\top}y+(X^{\top}X)^{-1}x_j[1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1}x_j^{\top}(X^{\top}X)^{-1}X^{\top}y-(X^{\top}X)^{-1}x_j[1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1}y_j \\ -[1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1}x_j^{\top}(X^{\top}X)^{-1}X^{\top}y+[1-x_j^{\top}(X^{\top}X)^{-1}x_j]^{-1}y_j \end{pmatrix} \\ =& \begin{pmatrix} \hat{\beta}+(X^{\top}X)^{-1}x_j\dfrac{1}{1-p_{jj}}x_j^{\top}\hat{\beta}-(X^{\top}X)^{-1}x_j\dfrac{1}{1-p_{jj}}y_j \\ -\dfrac{1}{1-p_{jj}}x_j^{\top}\hat{\beta}+\dfrac{1}{1-p_{jj}}y_j \end{pmatrix} \\ =& \begin{pmatrix} \hat{\beta}+\dfrac{1}{1-p_{jj}}(X^{\top}X)^{-1}x_j\hat{y}_j-\dfrac{1}{1-p_{jj}}(X^{\top}X)^{-1}x_jy_j \\ -\dfrac{1}{1-p_{jj}}\hat{y}_j+\dfrac{1}{1-p_{jj}}y_j \end{pmatrix} \\ =& \begin{pmatrix} \hat{\beta}-\dfrac{1}{1-p_{jj}}(X^{\top}X)^{-1}x_j\hat{\varepsilon}_j \\ \dfrac{\hat{\varepsilon}_j}{1-p_{jj}} \end{pmatrix} \end{align*}\]

由定理 14.16证明中倒数第二组公式即可得出结论。

(2)可以发现此时的假设检验问题即为在定理 14.7中取:

\[\begin{equation*} A= \begin{pmatrix} \mathbf{0} & \mathbf{0} \\ \mathbf{0} & 1 \end{pmatrix} \end{equation*}\]

和\(b=\mathbf{0}\)时的情况,此时\(\operatorname{SSE}_A=y^{\top}y-\hat{\beta}^{\top}X^{\top}y\),由(1)、性质 2.1.2(4)、性质 2.1.10(12)、定理 14.5和定理 14.2可得:

\[\begin{align*} &\operatorname{SSE}=y^{\top}y-\Big((\beta^{\star})^{\top},\eta^{\star}\Big)(X,d_j)^{\top}y=y^{\top}y-(\beta^{\star})^{\top}X^{\top}y-\eta^{\star}d_j^{\top}y \\ =&y^{\top}y-\left[\hat{\beta}-\frac{1}{1-p_{jj}}(X^{\top}X)^{-1}x_j\hat{\varepsilon}_j\right]^{\top}X^{\top}y-\frac{\hat{\varepsilon}_j}{1-p_{jj}}y_j \\ =&y^{\top}y-\hat{\beta}^{\top}X^{\top}y+\frac{\hat{\varepsilon}_j}{1-p_{jj}}x_j^{\top}(X^{\top}X)^{-1}X^{\top}y-\frac{\hat{\varepsilon}_j}{1-p_{jj}}y_j \\ =&y^{\top}y-\hat{\beta}^{\top}X^{\top}y+\frac{\hat{\varepsilon}_j}{1-p_{jj}}x_j^{\top}\hat{\beta}-\frac{\hat{\varepsilon}_j}{1-p_{jj}}y_j \\ =&y^{\top}y-\hat{\beta}^{\top}X^{\top}y+\frac{\hat{\varepsilon}_j}{1-p_{jj}}\hat{y}_j-\frac{\hat{\varepsilon}_j}{1-p_{jj}}y_j \\ =&y^{\top}y-\hat{\beta}^{\top}X^{\top}y-\frac{\hat{\varepsilon}_j^2}{1-p_{jj}}=(n-p)\hat{\sigma}^2-\frac{\hat{\varepsilon}_j^2}{1-p_{jj}} \end{align*}\]

于是可得:

\[\begin{equation*} \operatorname{SSE}_A-\operatorname{SSE}=y^{\top}y-\hat{\beta}^{\top}X^{\top}y-y^{\top}y+\hat{\beta}^{\top}X^{\top}y+\frac{\hat{\varepsilon}_j^2}{1-p_{jj}}=\frac{\hat{\varepsilon}_j^2}{1-p_{jj}} \end{equation*}\]

由定理 14.7(4)可得:

\[\begin{equation*} \frac{\operatorname{SSE}_A-\operatorname{SSE}}{\operatorname{SSE}/(n-p-1)}=\dfrac{\dfrac{(n-p-1)\hat{\varepsilon}_j^2}{1-p_{jj}}}{(n-p)\hat{\sigma}^2-\dfrac{\hat{\varepsilon}_j^2}{1-p_{jj}}}=\dfrac{\dfrac{(n-p-1)\hat{\varepsilon}_j^2}{\hat{\sigma}^2(1-p_{jj})}}{n-p-\dfrac{\hat{\varepsilon}_j^2}{\hat{\sigma}^2(1-p_{jj})}}=\frac{(n-p-1)r_j^2}{n-p-r_j^2}\sim\operatorname{F}_{1,n-p-1} \end{equation*}\]

拒绝域为\(\{F;F>\operatorname{F}_{1,n-p-1}(1-\alpha)\}\)。由性质 6.5.10(2)可得\(t\)检验时的情况。 ◻

14.5.4 复共线性与解决方案

note 14.12. 由定理 14.12(1)可知\(X^{\top}X\)正定且可逆,于是存在正交矩阵\(Q\)和\(\lambda_1, \lambda_2, \dots, \lambda_{p}\)使得:

\[\begin{equation*} X^{\top}X=Q^{\top}\operatorname{diag}\{\lambda_1, \lambda_2, \dots, \lambda_{p}\}Q \end{equation*}\]

其中\(\lambda_i>0\)。由性质 6.4.4(1)、性质 14.1.1(4)(5)、性质 2.1.5(2)、性质 2.1.10(11)、性质 2.1.11(1)和性质 2.1.5(3)可得:

\[\begin{align*} \operatorname{MSE}(\hat{\beta})&=\operatorname{tr}[\sigma^2(X^{\top}X)^{-1}]=\sigma^2\operatorname{tr}(X^{\top}X)^{-1}=\sigma^2\operatorname{tr} \left(Q^{\top}\operatorname{diag}\left\{\frac{1}{\lambda_1},\frac{1}{\lambda_2},\dots,\frac{1}{\lambda_{p}}\right\}Q\right) \\ &=\sigma^2\operatorname{tr} \left(\operatorname{diag}\left\{\frac{1}{\lambda_1},\frac{1}{\lambda_2},\dots,\frac{1}{\lambda_{p}}\right\}QQ^{\top}\right)=\sigma^2\sum_{i=1}^{p}\frac{1}{\lambda_i} \end{align*}\]

当\(X^{\top}X\)的一个特征根很小的时候,会导致\(\operatorname{MSE}(\hat{\beta})=\operatorname{tr}\operatorname{Cov}(\hat{\beta})\)很大。

从另一个角度来看,由性质 6.4.4(2)可得:

\[\begin{equation*} \operatorname{E}(\hat{\beta}^{\top}\hat{\beta})=\beta^{\top}\beta+\sigma^2\sum_{i=1}^{p}\frac{1}{\lambda_i} \end{equation*}\]

当\(X^{\top}X\)的一个特征根很小的时候,会导致\(\operatorname{E}(\hat{\beta}^{\top}\hat{\beta})\)比\(\beta^{\top}\beta\)大很多,也就是\(\hat{\beta}\)的平均长度比\(\beta\)大很多。

综上所述,当\(X^{\top}X\)的一个特征根很小的时候,线性回归模型的最小二乘估计不再是一个好的估计。此时的模型到底出了什么问题?

设\(\lambda\)是\(X^{\top}X\)的一个特征值,\(\alpha\)是其对应的特征向量。若\(\lambda\approx0\),则:

\[\begin{gather*} X^{\top}X\alpha=\lambda\alpha\approx\mathbf{0} \\ \alpha^{\top}X^{\top}X\alpha=\lambda\alpha^{\top}\alpha\approx0 \end{gather*}\]

也即\(||X\alpha||\approx0\),\(X\alpha\approx\mathbf{0}\),这等价于\(X\)的各列之间存在近似的线性相关关系,我们称之为复共线性(multicollinearity)关系。

度量复共线性严重程度的一个重要量是\(X^{\top}X\)的条件数数值分析条件数:

  1. \(k<100\):复共线性程度很小;

  2. \(100\leqslant k\leqslant1000\):存在中等程度或较强的复共线性;

  3. \(k>1000\):存在严重的复共线性。

另一个可以度量复共线性严重程度的指标为方差膨胀因子(variation inflation factor, VIF):定义\(\beta_i\)的方差膨胀因子为\((X^{\top}X)^{-1}(i,i)\),于是方差膨胀因子越大\(\operatorname{MSE}(\hat{\beta})\)越大。还可以证明VIF等于\(1-R^2\)的倒数。

14.5.4.1 岭回归

note 14.13. 由前述,复共线性程度严重时会导致\(\hat{\beta}\)的平均长度比\(\beta\)大很多,为了缓解这一问题,根据花书模型空间与正则项,可以将最小二乘法的目标函数\(||y-X\beta||^2\)修改为:

\[\begin{equation*} Q(\beta)=||y-X\beta||^2+\lambda||\beta||^2 \end{equation*}\]

其中\(\lambda\)为正则强度。类似定理 14.1可知此时的正则方程为:

\[\begin{equation*} (X^{\top}X+\lambda I_{p})\beta=X^{\top}y \end{equation*}\]

显然\(X^{\top}X+\lambda I_{p}\)是一个实对称阵,由矩阵多项式的特征值和定理 14.12(1)可知它还是一个正定阵,根据定理 2.17(6)可得\(X^{\top}X+\lambda I_{p}\)可逆,于是\(\beta\)的估计值\(\hat{\beta}(\lambda)=(X^{\top}X+\lambda I_{p})^{-1}X^{\top}y\)。

从这个结果来看,修改后的目标函数将会选择长度更小的估计,同时也增大了\(X^{\top}X\)的特征值,从而缓解复共线性问题。显然此时的\(\hat{\beta}\)已经不再是\(\beta\)的无偏估计,从性质 6.4.4(1)可知,它有可能会选择均方误差更小的估计。

Definition 14.24. 对于定义 14.17,称:

\[\begin{equation*} \hat{\beta}(\lambda)=(X^{\top}X+\lambda I_p)^{-1}X^{\top}y \end{equation*}\]

为\(\beta\)的岭估计(ridge estimate)。由定理 14.12(1),存在正交矩阵\(Q\)和\(\lambda_1, \lambda_2, \dots, \lambda_{p}\)使得:

\[\begin{equation*} \tilde{X}^{\top}\tilde{X}=Q^{\top}\operatorname{diag}\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\}Q \end{equation*}\]

其中\(\lambda_i>0\)。记\(Y=\tilde{X}Q^{\top},\;\delta_I=Q\beta_I\),于是模型可改写为:

\[\begin{equation*} y=\beta_0\mathbf{1}_n+Y\delta_I+\varepsilon,\quad\operatorname{E}(\varepsilon)=\mathbf{0},\quad\operatorname{Cov}(\varepsilon)=\sigma^2I_n \end{equation*}\]

称上述形式为典则形式(canonical form),\(\delta\)为典则回归系数。

Property 14.5.1. 中心化模型的岭估计具有如下性质:

  1. \(\hat{\alpha}_0=\overline{y},\;\hat{\delta}(\lambda)=Q\hat{\alpha}_I(\lambda)=\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}y,\;\operatorname{Cov}[\hat{\delta}(\lambda)]=\sigma^2\operatorname{diag}\left\{\dfrac{\lambda_1}{(\lambda_1+\lambda)^2},\dfrac{\lambda_2}{(\lambda_2+\lambda)^2},\dots,\dfrac{\lambda_{p-1}}{(\lambda_{p-1}+\lambda)^2}\right\}\);

  2. \(\operatorname{MSE}[\hat{\delta}(\lambda)]=\operatorname{MSE}[\hat{\alpha}_I(\lambda)]\);

  3. 存在\(\lambda>0\)使得\(\operatorname{MSE}[\hat{\delta}(\lambda)]<\operatorname{MSE}(\hat{\delta})\);

证明. (1)显然\(Y=\tilde{X}_cQ^{\top}\)也是中心化的,所以第一式成立。由正则方程、性质 2.1.2(4)、性质 2.1.10(11)和性质 2.1.11(1)可得:

\[\begin{align*} &\hat{\delta}(\lambda)=(Y^{\top}Y+\lambda I_{p-1})^{-1}Y^{\top}y=(Q\tilde{X}_c^{\top}\tilde{X}_cQ^{\top}+\lambda QI_{p-1}Q^{\top})^{-1}Q\tilde{X}_c^{\top}y \\ =&Q(\tilde{X}_c^{\top}\tilde{X}_c+\lambda I_{p-1})^{-1}Q^{\top}Q\tilde{X}_c^{\top}y=Q(\tilde{X}_c^{\top}\tilde{X}_c+\lambda I_{p-1})^{-1}\tilde{X}_c^{\top}y=Q\hat{\alpha}_I(\lambda) \end{align*}\]

注意到:

\[\begin{equation*} Y^{\top}Y=Q\tilde{X}_c^{\top}\tilde{X}_cQ^{\top}=\operatorname{diag}\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\} \end{equation*}\]

所以:

\[\begin{equation*} \hat{\delta}(\lambda)=\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}y \end{equation*}\]

根据性质 6.4.3(3)和性质 2.1.10(12)可得:

\[\begin{align*} &\operatorname{Cov}[\hat{\delta}(\lambda)]=\operatorname{Cov}[\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}y] \\ =&\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}\sigma^2I_n[\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}]^{\top} \\ =&\sigma^2\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}Y\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1} \\ =&\sigma^2\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}\operatorname{diag}\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\} \\ &\cdot\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1} \\ =&\sigma^2\operatorname{diag}\left\{\frac{\lambda_1}{(\lambda_1+\lambda)^2},\frac{\lambda_2}{(\lambda_2+\lambda)^2},\dots,\frac{\lambda_{p-1}}{(\lambda_{p-1}+\lambda)^2}\right\} \end{align*}\]

(2)由(1)、性质 6.4.4(1)、性质 6.4.3(3)、性质 2.1.5(3)、性质 5.4.3(6)和性质 2.1.2(4)可得:

\[\begin{align*} \operatorname{MSE}[\hat{\delta}(\lambda)]&=\operatorname{MSE}[Q\hat{\alpha}_I(\lambda)]=\operatorname{tr}\operatorname{Cov}[Q\hat{\alpha}_I(\lambda)] \\ &\quad+\{\operatorname{E}[Q\hat{\alpha}_I(\lambda)]-Q\alpha_I(\lambda)\}^{\top}\{\operatorname{E}[Q\hat{\alpha}_I(\lambda)]-Q\alpha_I(\lambda)\} \\ &=\operatorname{tr}\{Q\operatorname{Cov}[\hat{\alpha}_I(\lambda)]Q^{\top}\}+\{\operatorname{E}[\hat{\alpha}_I(\lambda)]-\alpha_I(\lambda)\}^{\top}Q^{\top}Q\{\operatorname{E}[\hat{\alpha}_I(\lambda)]-\alpha_I(\lambda)\} \\ &=\operatorname{tr}\operatorname{Cov}[\hat{\alpha}_I(\lambda)]+\{\operatorname{E}[\hat{\alpha}_I(\lambda)]-\alpha_I(\lambda)\}^{\top}\{\operatorname{E}[\hat{\alpha}_I(\lambda)]-\alpha_I(\lambda)\}=\operatorname{MSE}[\hat{\alpha}_I(\lambda)] \end{align*}\]

(3)由(1)可得:

\[\begin{align*} &\operatorname{E}[\hat{\delta}(\lambda)]=\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}\operatorname{E}(y) \\ =&\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}(\alpha_0\mathbf{1}_n+Y\delta) \\ =&\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}Y^{\top}Y\delta \\ =&\left(\operatorname{diag}\left\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\right\}+\lambda I_{p-1}\right)^{-1}\operatorname{diag}\{\lambda_1, \lambda_2, \dots, \lambda_{p-1}\}\delta \\ =&\left(\frac{\lambda_1}{\lambda_1+\lambda}\delta_1,\frac{\lambda_2}{\lambda_2+\lambda}\delta_2,\dots,\frac{\lambda_{p-1}}{\lambda_{p-1}+\lambda}\delta_{p-1}\right)^{\top} \end{align*}\]

所以:

\[\begin{gather*} \operatorname{E}[\hat{\delta}(\lambda)]-\delta=\left(-\frac{\lambda}{\lambda_1+\lambda}\delta_1,-\frac{\lambda}{\lambda_2+\lambda}\delta_2,\dots,-\frac{\lambda}{\lambda_{p-1}+\lambda}\delta_{p-1}\right)^{\top} \end{gather*}\]

于是由性质 6.4.4(1)、(1)、性质 2.1.5(2)可得:

\[\begin{gather*} \operatorname{MSE}[\hat{\delta}(\lambda)]=\operatorname{tr}\operatorname{Cov}[\hat{\delta}(\lambda)]+||\operatorname{E}[\hat{\delta}(\lambda)]-\delta||^2=\sigma^2\sum_{i=1}^{p-1}\frac{\lambda_i}{(\lambda_i+\lambda)^2}+\sum_{i=1}^{p-1}\frac{\lambda^2\delta_i^2}{(\lambda_i+\lambda)^2} \\ \begin{aligned} \frac{\mathop{}\!\mathrm{d}\operatorname{MSE}[\hat{\delta}(\lambda)]}{\mathop{}\!\mathrm{d}\lambda}&=-2\sigma^2\sum_{i=1}^{p-1}\frac{\lambda_i}{(\lambda_i+\lambda)^3}+2\lambda\sum_{i=1}^{p-1}\frac{\delta_i^2}{(\lambda_i+\lambda)^2}-2\sum_{i=1}^{p-1}\frac{\lambda^2\delta_i^2}{(\lambda_i+\lambda)^3} \\ &=-2\sigma^2\sum_{i=1}^{p-1}\frac{\lambda_i}{(\lambda_i+\lambda)^3}+2\lambda\sum_{i=1}^{p-1}\frac{\lambda_i\delta_i^2}{(\lambda_i+\lambda)^3}=\sum_{i=1}^{p-1}(\lambda\delta_i^2-\sigma^2)\frac{2\lambda_i}{(\lambda_i+\lambda)^3} \end{aligned} \end{gather*}\]

当\(\lambda>0\)但较小时,由上式看出此时可以有\(\operatorname{MSE}[\hat{\delta}(\lambda)]\)关于\(\lambda\)的导数小于\(0\),所以存在\(\lambda^{\star}>0\),当\(0<\lambda<\lambda^{\star}\)时\(\operatorname{MSE}[\hat{\delta}(\lambda)]\)是\(\lambda\)的单调减函数,也就是说在这个区间上\(\operatorname{MSE}[\hat{\delta}(\lambda)]<\operatorname{MSE}(\hat{\delta})\)。 ◻

note 14.14. 理论说明了存在较小的\(\lambda\)使得岭估计优于最小二乘估计,下面给出两个选择参数\(\lambda\)的方法。

(1)Hoerl-Kennard公式:由性质 14.5.1(3),考虑方程:

\[\begin{equation*} \sum_{i=1}^{p-1}(\lambda\delta_i^2-\sigma^2)\frac{2\lambda_i}{(\lambda_i+\lambda)^3} \end{equation*}\]

若\(\lambda\delta_i^2-\sigma^2<0,\;i=1,2,\dots,p-1\),则此时\(\operatorname{MSE}[\hat{\delta}(\lambda)]\)仍然小于\(\operatorname{MSE}(\hat{\delta})\),所以可取:

\[\begin{equation*} \lambda=\max_i\frac{\hat{\sigma}^2}{\hat{\delta}_i^2} \end{equation*}\]

(2)岭迹法:将\(\hat{\delta}_1(\lambda),\hat{\delta}_2(\lambda),\dots,\hat{\delta}_{p-1}(\lambda)\)随着\(\lambda\)变化的趋势画在同一张图上,选择\(\lambda\)值使得各个回归系数的估计值大体上稳定并且估计值的符号较为合理(根据实际意义判断),同时还需使得\(\operatorname{SSE}\)上升不太多。

14.6 方差分析模型

方差分析(analysis of variance, ANOVA)模型是一种特殊的正态线性模型,它的自变量取值只能为\(0\)或\(1\)。

14.6.1 单因子方差分析

Definition 14.25. 设因子\(A\)有\(a\)个水平,分别为\(A_1, A_2, \dots, A_{a}\),有数据:

表 14.1 单因子试验数据
水平 观测值
\(A_1\) \(y_{11}\) \(y_{12}\) \(\cdots\) \(y_{1n_1}\)
\(A_2\) \(y_{21}\) \(y_{22}\) \(\cdots\) \(y_{2n_2}\)
\(\vdots\) \(\vdots\) \(\vdots\) \(\ddots\) \(\vdots\)
\(A_a\) \(y_{a1}\) \(y_{a2}\) \(\cdots\) \(y_{an_a}\)

其中\(y_{ij}\)表示在第\(i\)个水平\(A_i\)下第\(j\)次重复试验的观察值。记\(n=\sum\limits_{i=1}^{a}n_i\),则此时的单因子方差分析模型为:

\[\begin{equation*} \tag{14.1} \begin{cases} y_{ij}=\mu+\alpha_i+\varepsilon_{ij} \\ \varepsilon_{ij}\quad\mathrm{i.i.d.~}N(0,\sigma^2) \\ \operatorname{s.t.}\quad\sum\limits_{i=1}^an_i\alpha_i=0 \end{cases} \qquad i=1,2,\dots,a,\;j=1,2,\dots,n_i \end{equation*}\]

称模型中的约束条件为边界条件(boundary condition),\(\mu\)为一般平均(这里表示因子\(A\)的这\(a\)个水平对数据的一般影响),\(\alpha_i\)为水平\(A_i\)的效应(effect),\(\varepsilon_{ij}\)为随机误差。于是模型的\(y\)值向量和对应的设计阵、参数向量可写作:

\[\begin{gather*} y=(y_{11},y_{12},\dots,y_{1n_1},y_{21},y_{22},\dots,y_{2n_2},\dots,y_{a1},y_{a2},\dots,y_{an_a})^{\top} \\ X= \begin{pmatrix} \mathbf{1}_{n_1} & \mathbf{1}_{n_1} & \mathbf{0} & \cdots & \mathbf{0} \\ \mathbf{1}_{n_2} & \mathbf{0} & \mathbf{1}_{n_2} & \cdots & \mathbf{0} \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ \mathbf{1}_{n_a} & \mathbf{0} & \mathbf{0} & \cdots & \mathbf{1}_{n_a} \end{pmatrix},\quad \beta= \begin{pmatrix} \mu \\ \alpha_1 \\ \alpha_2 \\ \cdots \\ \alpha_a \end{pmatrix} \end{gather*}\]

14.6.1.1 参数估计

Definition 14.26. 对于公式 14.1,称满足条件\(\sum\limits_{i=1}^{a}c_i=0\)的函数\(\sum\limits_{i=1}^{a}c_i\alpha_i\)为一个对照(contrast)。

Theorem 14.18. 对于公式 14.1,记:

\[\begin{equation*} y_{..}=\sum_{i=1}^a\sum_{j=1}^{n_i}y_{ij},\quad\overline{y}_{..}=\frac{y_{..}}{n},\quad y_{i.}=\sum_{j=1}^{n_i}y_{ij},\quad \overline{y}_{i.}=\frac{y_{i.}}{n_i},\;i=1,2,\dots,a \end{equation*}\]

则有如下结论:

  1. \(\operatorname{rank}(X)=a\);

  2. 正则方程\(X^{\top}X\beta=X^{\top}y\)为:

    \[\begin{equation*} n\mu+\sum_{i=1}^{a}n_i\alpha_i=y_{..},\quad n_i\mu+n_i\alpha_i=y_{i.},\quad i=1,2,\dots,a \end{equation*}\]

  3. \(\mu\)和\(\alpha_i\)是不可估的;

  4. \(\mu\)和\(\alpha_i\)在边界条件下的解为:

    \[\begin{equation*} \hat{\mu}=\overline{y}_{..},\quad\hat{\alpha}_i=\overline{y}_{i.}-\overline{y}_{..} \end{equation*}\]

    \(\sigma^2\)的无偏估计为\(\operatorname{SSE}/(n-a)\);

  5. \(\mu+\alpha_i,\;i=1,2,\dots,a\)是可估的且线性无关,进而任一可估函数都可表示为:

    \[\begin{equation*} \sum_{i=1}^{a}c_i(\mu+\alpha_i)=\mu\sum_{i=1}^{a}c_i+\sum_{i=1}^{a}c_i\alpha_i \end{equation*}\]

  6. \(\sum\limits_{i=1}^{a}c_i\alpha_i\)可估当且仅当\(\sum\limits_{i=1}^{a}c_i\alpha_i\)是一个对照;

  7. 对照\(\sum\limits_{i=1}^{a}c_i\alpha_i\)唯一的BLUE为\(\sum\limits_{i=1}^{a}c_i\overline{y}_{i.}\)。

证明. (1)通过矩阵的初等行列变换显然可得。

(2)将\(X\)和\(\beta\)带入运算即可得到。

(3)由可估函数的定义,若\(\mu\)可估,则存在\(\alpha\)使得:

\[\begin{equation*} \operatorname{E}(\alpha^{\top}y)=\mu=(1,0,0,\dots,0)^{\top}\beta \end{equation*}\]

由性质 14.1.1(1)可知此时关于\(a\)的线性方程组:

\[\begin{equation*} \begin{pmatrix} \mathbf{1}_{n_1}^{\top} & \mathbf{1}_{n_2}^{\top} & \mathbf{1}_{n_3}^{\top} & \cdots & \mathbf{1}_{n_a}^{\top} \\ \mathbf{1}_{n_1}^{\top} & \mathbf{0} & \mathbf{0} & \cdots & \mathbf{0} \\ \mathbf{0} & \mathbf{1}_{n_2}^{\top} & \mathbf{0} & \cdots & \mathbf{0} \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ \mathbf{0} & \mathbf{0} & \mathbf{0} & \cdots & \mathbf{1}_{n_a}^{\top} \end{pmatrix}a= \begin{pmatrix} 1 \\ 0 \\ 0 \\ \vdots \\ 0 \end{pmatrix} \end{equation*}\]

有解,但将增广矩阵的第一行依次减去第二行到第\(a+1\)行,第一行便变为方程\(0=1\),由定理 2.3可知该线性方程组无解,于是\(\mu\)不可估。

若\(\alpha_i\)可估,则关于\(a\)的线性方程组:

\[\begin{equation*} \begin{pmatrix} \mathbf{1}_{n_1}^{\top} & \mathbf{1}_{n_2}^{\top} & \mathbf{1}_{n_3}^{\top} & \cdots & \mathbf{1}_{n_a}^{\top} \\ \mathbf{1}_{n_1}^{\top} & \mathbf{0} & \mathbf{0} & \cdots & \mathbf{0} \\ \mathbf{0} & \mathbf{1}_{n_2}^{\top} & \mathbf{0} & \cdots & \mathbf{0} \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ \mathbf{0} & \mathbf{0} & \mathbf{0} & \cdots & \mathbf{1}_{n_a}^{\top} \end{pmatrix}a=(0,0,\dots,1,0,0,\dots,0)^{\top} \end{equation*}\]

有解,其中等式右边向量第\(i+1\)个分量为\(1\),其它分量都为\(0\)。将增广矩阵的第一行依次减去除了\(i+1\)行的所有行,再用第\(i+1\)行减去第一行,第\(i+1\)行便变为\(0=1\),由定理 2.3可知该线性方程组无解,于是\(\alpha_i\)不可估。

(4)考虑到模型中增加的约束条件\(\sum\limits_{i=1}^{a}n_i\alpha_i=0\),由(2)可直接得到关于\(\mu\)和\(\alpha_i\)的结论。由定理 14.2和(1)可直接得到关于\(\sigma^2\)的结论

(5)类似(3)可得,关于表示方法的结论可由性质 14.1.1(2)得到。

(6)由(5)可得。

(7)由(6)可知此时\(\sum\limits_{i=1}^{a}c_i\alpha_i\)可估,由性质 14.1.1(3)可知其最小二乘解与\(X^{\top}X\beta=X^{\top}y\)解的选择无关,用(4)代入可得该对照的最小二乘解为:

\[\begin{equation*} \sum_{i=1}^{a}c_i\hat{\alpha_i}=\sum_{i=1}^{a}c_i\overline{y}_{i.}-\sum_{i=1}^{a}c_i\overline{y}_{..}=\sum_{i=1}^{a}c_i\overline{y}_{i.} \end{equation*}\]

由性质 14.1.1(6)可得上式是唯一的BLUE。 ◻

14.6.1.2 模型的假设检验

note 14.15. 对于公式 14.1,我们关心的是因子\(A\)的\(a\)个水平效应是否有显著差异,此时的原假设为:

\[\begin{equation*} H_0:\alpha_1=\alpha_2=\cdots=\alpha_a \end{equation*}\]

注意到上式的等价形式为:

\[\begin{equation*} H_0:\alpha_1-\alpha_a=\alpha_2-\alpha_a=\alpha_{a-1}-\alpha_a=\mathbf{0} \end{equation*}\]

令\(H=(I_{a-1},-\mathbf{1}_{a-1}),\;\alpha=(\alpha_1, \alpha_2, \dots, \alpha_{a})^{\top}\),则上述原假设可写作矩阵形式\(H\alpha=\mathbf{0}\)。

Theorem 14.19. 对于公式 14.1,设\(H=(I_{a-1},-\mathbf{1}_{a-1}),\;\alpha=(\alpha_1, \alpha_2, \dots, \alpha_{a})^{\top}\),则假设检验问题:

\[\begin{equation*} H_0:\alpha_1=\alpha_2=\cdots=\alpha_a \end{equation*}\]

的检验统计量和置信水平为\(1-\alpha\)的拒绝域分别为:

\[\begin{equation*} F=\frac{(\operatorname{SSE}_H-\operatorname{SSE})/(a-1)}{\operatorname{SSE}/(n-a)},\quad\{F:F>\operatorname{F}_{a-1,n-a}(\alpha)\} \end{equation*}\]

证明. 由定理 14.18(1)可知\(\operatorname{rank}(X)=a\),由\(H\)的定义可知\(\operatorname{rank}(H)=a-1\),根据定理 14.18(6)可知\(\mathcal{M}(H^{\top})\subseteq\mathcal{M}(X^{\top})\),所以由定理 14.7(5)直接可得出结论。 ◻

14.6.1.3 对比的假设检验

Theorem 14.20. 对于公式 14.1,设\(H=(c_1, c_2, \dots, c_{a}),\;\alpha=(\alpha_1, \alpha_2, \dots, \alpha_{a})^{\top}\),则对比\(\sum\limits_{i=1}^{a}c_i\alpha_i\)的假设检验问题:

\[\begin{equation*} H_0:\sum_{i=1}^{a}c_i\alpha_i=0,\quad H_1:\sum_{i=1}^{a}c_i\alpha_i\ne0 \end{equation*}\]

的检验统计量和置信水平为\(1-\alpha\)的拒绝域分别为:

\[\begin{equation*} F=\frac{\operatorname{SSE}_H-\operatorname{SSE}}{\operatorname{SSE}/(n-a)},\quad\{F:F>\operatorname{F}_{1,n-a}(\alpha)\} \end{equation*}\]

证明. 由定理 14.18(6)和定理 14.19立即可得。 ◻

接下来介绍各水平等重复情形下Duncan多重比较法。

note 14.16. 请注意Duncan多重比较法并没有作多重假设检验修正。

Definition 14.27. 将\(a\)个水平下观察值的平均值\(\overline{y}_{1.},\overline{y}_{2.},\dots,\overline{y}_{a.}\)从小到大排序。如果\(\overline{y}_i\)与\(\overline{y}_j\)(\(\overline{y}_i\leqslant\overline{y}_j\))在排序后中间有\(p-2,\;p\geqslant2\)个数,那么称\(\overline{y}_j-\overline{y}_i\)为\(p\)级极差,记为\(R_p\)。

Theorem 14.21. 对于公式 14.1,多重假设检验问题:

\[\begin{equation*} H_0:\alpha_i=\alpha_j,\;\forall\;i\ne j \end{equation*}\]

的检验统计量和置信水平为\(1-\alpha\)的拒绝域分别为:

\[\begin{equation*} r(p,n-a)=\frac{R_p}{\sqrt{MSE/m}},\quad\{r:r>r_{p,f}(\alpha)\} \end{equation*}\]

其中\(p\)为极差级数,\(m\)为因子\(A\)每个水平下重复实验的次数。

证明. 设\(\overline{y}_i-\overline{y}_j\)是\(p\)级极差。

(1)将\(r(p,n-a)\)分子分母同除\(\sigma\)可得:

\[\begin{equation*} r(p,n-a)=\frac{\dfrac{R_p}{\sigma/\sqrt{m}}}{\sqrt{MSE/\sigma^2}} \end{equation*}\]

注意到分母:

\[\begin{equation*} \frac{MSe}{\sigma^2}=\frac{1}{n-a}\frac{SSe}{\sigma^2} \end{equation*}\]

由性质 14.2.1(2)可知上式是一个服从\(\chi^2(f)\)分布变量的\(\dfrac{1}{f}\)倍的变量,其分布与\(\mu,\;\sigma^2\)无关。

当\(\alpha_i=\alpha_j\)时:

\[\begin{equation*} \frac{\overline{y}_{i.}-\nu}{\sigma/\sqrt{m}}\sim N(0,\;1),\quad\frac{\overline{y}_{j.}-\nu}{\sigma/\sqrt{m}}\sim N(0,\;1) \end{equation*}\]

这里\(\nu=\mu+\alpha_i=\mu+\alpha_j\),上式中两个随机变量的分布与\(\mu,\sigma^2\)都无关,所以分子:

\[\begin{equation*} \frac{R_p}{\sigma/\sqrt{m}}=\max(\frac{\overline{y}_{j.}-\nu}{\sigma/\sqrt{m}},\frac{\overline{y}_{i.}-\nu}{\sigma/\sqrt{m}})-\min(\frac{\overline{y}_{j.}-\nu}{\sigma/\sqrt{m}},\frac{\overline{y}_{i.}-\nu}{\sigma/\sqrt{m}}) \end{equation*}\]

也与\(\mu,\sigma^2\)无关。

综上,原假设情况下\(r(p,n-a)\)与\(\mu,\sigma^2\)无关。

(2)当\(\alpha_i=\alpha_j\)不成立时,对应的\(R_p\)会较大。因此当\(r(p,n-a)\)较大时,有理由怀疑零假设。所以\(H_0\)的拒绝域是右向单尾的,置信水平为\(1-\alpha\)的拒绝域为\(\{r:r>r_{p,f}(\alpha)\}\)。 ◻

note 14.17. Duncan多重比较的检验步骤为:将\(\overline{y}_{1.},\overline{y}_{2.},\dots,\overline{y}_{a.}\)从小到大排序为\(\overline{y}^1,\overline{y}^2,\dots,\overline{y}^a\)。令:

\[\begin{equation*} r_{p,n-a}(\alpha)\sqrt{\frac{MSe}{m}}=R_p^{\star} \end{equation*}\]

按以下顺序进行比较:

\[\begin{gather*} \overline{y}^a-\overline{y}^1\text{与$R_a^{\star}$进行比较} \\ \overline{y}^a-\overline{y}^2\text{与$R_{a-1}^{\star}$进行比较} \\ \cdots\cdots \\ \overline{y}^a-\overline{y}^{a-1}\text{与$R_2^{\star}$进行比较} \\ \overline{y}^{a-1}-\overline{y}^1\text{与$R_{a-1}^{\star}$进行比较} \\ \overline{y}^{a-1}-\overline{y}^2\text{与$R_{a-2}^{\star}$进行比较} \\ \cdots\cdots \end{gather*}\]

若前者大于后者,则拒绝原假设,直到全部\(\binom{a}{2}\)对水平均值比较完为止。因为\(r_{p_n-a}\)的分布不好求解,使用Monte Carlo方法求\(r_{p,n-a}(\alpha)\)的近似值。

Algorithm 14.2 Duncan多重比较法统计量分布的蒙特卡洛模拟

Input: \(m\)、\(p\)、\(n-a\)、\(N\) (组内重复次数、极差的级数、SSe的自由度、模拟次数)

Output: \(r(p,n-a)\)的模拟分布

初始化模拟值存储向量:\(List\gets\varnothing\)

for \(i\gets1\) to \(N\) do

生成\(p\)个随机数\(x_j\sim\operatorname{N}(0,1),\;j=1,2,\dots,p\)

计算\(\frac{R_p}{\sigma/\sqrt{m}}\):

\[\begin{equation*} \frac{R_p}{\sigma/\sqrt{m}}=\max\{x_j:j=1,2,\dots,p\}-\min\{x_j:j=1,2,\dots,p\} \end{equation*}\]

从\(\chi^2(n-a)\)中产生一个随机数记为\(\chi^2\)

计算\(r(p,n-a)\):

\[\begin{equation*} r(p,n-a)=\frac{\dfrac{R_p}{\sigma/\sqrt{m}}}{\sqrt{\chi^2/(n-a)}} \end{equation*}\]

将\(r(p,n-a)\)加入\(List\)

end for

return \(List\)

14.6.1.4 实际计算

Theorem 14.22. \(\operatorname{SSE}_H\)和\(\operatorname{SSE}\)有如下计算公式:

\[\begin{equation*} \operatorname{SSE}_H-\operatorname{SSE}=\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i}-\frac{y_{..}^2}{n},\quad \operatorname{SSE}=\sum_{i=1}^{a}\sum_{j=1}^{n_i}y_{ij}^2-\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i} \end{equation*}\]

证明. 在约束\(H\alpha=\mathbf{0}\)的情况下,因为\(\alpha_1=\alpha_2=\cdots=\alpha_a\),所以可将它们并入\(\mu\),于是\(\mu\)的估计为\(\overline{y}_{..}\),此时:

\[\begin{equation*} \operatorname{RSS}_H(\mu)=\hat{\mu}\mathbf{1}_n^{\top}y=\overline{y}_{..}y_{..}=\frac{y_{..}}{n}y_{..}=\frac{y_{..}^2}{n} \end{equation*}\]

在无约束的情况下由定理 14.18(4)可得:

\[\begin{align*} \operatorname{RSS}(\beta)&=\hat{\beta}^{\top}X^{\top}y=\hat{\mu}y_{..}+\sum_{i=1}^{a}\hat{\alpha}_iy_{i.} =\frac{y_{..}}{n}y_{..}+\sum_{i=1}^{a}(\overline{y}_{i.}-\overline{y}_{..})y_{i.} \\ &=\frac{y_{..}^2}{n}+\sum_{i=1}^{a}\left(\frac{y_{i.}}{n_i}-\frac{y_{..}}{n}\right)y_{i.} =\frac{y_{..}^2}{n}+\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i}-\sum_{i=1}^{a}y_{i.}\frac{y_{..}}{n}=\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i} \end{align*}\]

于是由定理 14.5可得:

\[\begin{equation*} \operatorname{SSE}=y^{\top}y-\operatorname{RSS}(\beta)=\sum_{i=1}^{a}\sum_{j=1}^{n_i}y_{ij}^2-\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i} \end{equation*}\]

所以:

\[\begin{align*} \operatorname{SSE}_H-\operatorname{SSE}=y^{\top}y-\operatorname{RSS}_H(\mu)-y^{\top}y+\operatorname{RSS}(\beta)=\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i}-\frac{y_{..}^2}{n} \end{align*}\]

◻

Definition 14.28. 对于公式 14.1,令\(H=(I_{a-1},-\mathbf{1}_{a-1}),\;\alpha=(\alpha_1, \alpha_2, \dots, \alpha_{a})^{\top}\)。记\(\operatorname{SSE}_H-\operatorname{SSE}\)为\(SSA\),称其为因子\(A\)的平方和或组间平方和。称\(\operatorname{SSE}\)为组内平方和。分别称\(MSA=SSA/(a-1)\)和\(MSE=\operatorname{SSE}/(n-a)\)为因子\(A\)和误差的均方和。

note 14.18. 下给出上述定义的解释。

记\(\overline{\varepsilon}_{i.}=\frac{1}{n_i}\sum\limits_{j=1}^{n_i}\varepsilon_{ij}\),由定理 14.22可得:

\[\begin{equation*} \operatorname{SSE}=\sum_{i=1}^{a}\sum_{j=1}^{n_i}y_{ij}^2-\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i}=\sum_{i=1}^{a}\sum_{j=1}^{n_i}(y_{ij}-\overline{y}_{i.})^2=\sum_{i=1}^{a}\sum_{j=1}^{n_i}(\varepsilon_{ij}-\overline{\varepsilon}_{i.})^2 \end{equation*}\]

可见该项完全是由误差引起的。

对于\(\operatorname{SSA}\),有:

\[\begin{equation*} \operatorname{SSA}=\sum_{i=1}^{a}\frac{y_{i.}^2}{n_i}-\frac{y_{..}^2}{n}=\sum_{i=1}^{a}n_i(\overline{y}_{i.}-\overline{y}_{..})^2 \end{equation*}\]

可见该项是由因子\(A\)的水平变化所引起的观测数据的变差平方和。

表 14.2 单因子试验方差分析表
来源 平方和 自由度 均方和 F值
因子A SSA \(f_A=a-1\) \(\operatorname{MSA}=\dfrac{\operatorname{SSA}}{a-1}\) \(F=\dfrac{MSA}{MSe}\)
误差 SSE \(f_e=n-a\) \(\operatorname{MSe}=\dfrac{\operatorname{SSE}}{n-a}\)
总 SST \(f_T=n-1\)

14.6.1.5 置信区间

Theorem 14.23. 任意\(m\)个对照\(\sum\limits_{i=1}^{a}c_i^{(j)}\alpha_i,\;j=1,2,\dots,m\)的置信水平为\(1-\alpha\)的Bonferroni置信区间和所有对照\(\sum\limits_{i=1}^{a}c_i\alpha_i\)的置信水平为\(1-\alpha\)的Scheffe置信区间分别为:

\[\begin{gather*} \sum_{i=1}^{a}c_i^{(j)}\overline{y}_{i.}\pm t_{n-a}\left(\frac{\alpha}{2m}\right)\sqrt{\hat{\sigma}^2\sum_{i=1}^{a}\frac{(c_i^{(j)})^2}{n_i}},\quad j=1,2,\dots,m \\ \sum_{i=1}^{a}c_i\overline{y}_{i.}\pm\sqrt{(a-1)\hat{\sigma}^2F_{a-1,n-a}(\alpha)\sum_{i=1}^{a}\frac{c_i^2}{n_i}} \end{gather*}\]

特别的。对于\(m\)个形如\(a_i-a_j\)的对照的置信水平为\(1-\alpha\)的Bonferroni置信区间和所有\(a_i-a_j\)的置信水平为\(1-\alpha\)的Scheffe置信区间为:

\[\begin{gather*} \overline{y}_{i.}-\overline{y}_{j.}\pm t_{n-a}\left(\frac{\alpha}{2m}\right)\sqrt{\hat{\sigma}^2\left(\frac{1}{n_i}+\frac{1}{n_j}\right)} \\ \overline{y}_{i.}-\overline{y}_{j.}\pm\sqrt{(a-1)\hat{\sigma}^2F_{a-1,n-a}(\alpha)\left(\frac{1}{n_i}+\frac{1}{n_j}\right)} \end{gather*}\]

证明. 根据定理 14.10和定理 14.9,只需证明:

\[\begin{gather*} \left(0,c_1, c_2, \dots, c_{a}\right)^{\top}(X^{\top}X)^-\left(0,c_1, c_2, \dots, c_{a}\right)=\sum_{i=1}^{a}\frac{(c_i^{(j)})^2}{n_i} \\ (e_i-e_j)^{\top}(X^{\top}X)^-(e_i-e_j)=\frac{1}{n_i}+\frac{1}{n_j} \end{gather*}\]

其中\(e_i,e_j\)分别是第\(i\)个分量和第\(j\)各分量为\(1\)的单位向量,搞明白\(A(X^{\top}X)^-A^{\top}\)后回来补充 ◻

14.6.2 可加效应的两因子方差分析

可加的含义与无重复

Definition 14.29. 设因子\(A\)有\(a\)个水平,分别为\(A_1, A_2, \dots, A_{a}\),因子\(B\)有\(b\)个水平,分别为\(B_1, B_2, \dots, B_{b}\),有数据:

表 14.3 无重复两因子试验数据表
因子B因子A \(B_1\) \(B_2\) \(\cdots\) \(B_b\)
\(A_1\) \(y_{11}\) \(y_{12}\) \(\cdots\) \(y_{1b}\)
\(A_2\) \(y_{21}\) \(y_{22}\) \(\cdots\) \(y_{2b}\)
\(\vdots\) \(\vdots\) \(\vdots\) \(\vdots\)
\(A_a\) \(y_{a1}\) \(y_{a2}\) \(\cdots\) \(y_{ab}\)

其中\(y_{ij}\)表示在因子A的第\(i\)个水平\(A_i\)和因子B的第\(j\)个水平\(B_j\)下试验的观察值。记\(n=ab\),则此时可加效应的两因子方差分析模型为:

\[\begin{equation*} \tag{14.2} \begin{cases} y_{ij}=\mu+\tau_i+\beta_j+\varepsilon_{ij} \\ \varepsilon_{ij}\quad\mathrm{i.i.d.~}N(0,\sigma^2) \\ \operatorname{s.t.}\quad\sum\limits_{i=1}^a\tau_i=0,\quad\sum\limits_{j=1}^b\beta_j=0 \\ i=1,2,\dots,a,\;j=1,2,\dots,b \end{cases} \end{equation*}\]

称\(\mu\)为一般平均,表示\(ab\)个总体的均值的平均值;称\(\tau_i\)为因子A第\(i\)个水平\(A_i\)的主效应;称\(\beta_j\)为因子B第\(j\)个水平\(B_j\)的主效应。\(\varepsilon_{ij}\)为随机误差。于是模型的\(y\)值向量和对应的设计阵、参数向量可写作:

\[\begin{gather*} y=(y_{11},y_{12},\dots,y_{1b},y_{21},y_{22},\dots,y_{2b},\dots,y_{a1},y_{a2},\dots,y_{ab})^{\top} \\ \beta=(\mu,\alpha_1,\alpha_2,\dots,\alpha_a,\beta_1,\beta_2,\dots,\beta_b)^{\top} \\ X= \begin{pmatrix} \mathbf{1}_b & \mathbf{1}_b & \mathbf{0} & \cdots & \mathbf{0} & I_b \\ \mathbf{1}_b & \mathbf{0} & \mathbf{1}_b & \cdots & \mathbf{0} & I_b \\ \vdots & \vdots & \vdots & \ddots & \mathbf{0} & I_b \\ \mathbf{1}_b & \mathbf{0} & \mathbf{0} & \cdots & \mathbf{1}_b & I_b \end{pmatrix} \end{gather*}\]

14.7 广义线性模型

在线性模型中,我们通过线性预测子\(x_i^{\top}\beta\)直接建模响应变量\(y_i\)的条件均值,即:

\[\begin{equation*} \mu_i=\operatorname{E}(y_i\mid x_i)=x_i^{\top}\beta \end{equation*}\]

然而,当\(y_i\)服从Bernoulli分布、Poisson分布等非正态分布时,其条件均值\(\mu_i\)通常受到取值范围的限制。例如,Bernoulli分布的条件均值必须属于\((0,1)\),Poisson分布的条件均值必须为正数,因而不能直接令\(\mu_i=x_i^{\top}\beta\)。

为了将线性模型中建模条件均值的思想推广到更广泛的响应变量分布,一个自然的想法是引入一个可逆的函数\(g(\cdot)\),对条件均值\(\mu_i\)进行变换,使变换后的均值能够由线性预测子建模:

\[\begin{equation*} g(\mu_i)=\eta_i=x_i^{\top}\beta \end{equation*}\]

Definition 14.30. 称以下模型为广义线性模型1:

\[\begin{equation*} y_i\mid x_i\sim F(\mu_i,\phi), \quad i=1,2,\dots,n \end{equation*}\]

其中\(\{y_i\}\)相互独立,\(F\)属于指数分布族,有:

\[\begin{equation*} f(y_i;\theta_i,\phi)=\exp\left\{\frac{y_i\theta_i-b(\theta_i)}{a(\phi)}+c(y_i,\phi)\right\} \end{equation*}\]

记:

\[\begin{equation*} \mu_i=\operatorname{E}(y_i\mid x_i)=b'(\theta_i), \quad\operatorname{Var}(y_i\mid x_i)=a(\phi)b''(\theta_i) \end{equation*}\]

并通过链接函数(link function)\(g(\cdot)\)将条件均值与线性预测子联系:

\[\begin{equation*} g(\mu_i)=\eta_i=x_i^{\top}\beta \end{equation*}\]

其中\(x_i\)为第\(i\)个观测的\(p\times1\)特征向量,\(\beta\)为\(p\times1\)的回归系数向量,\(\phi\)为离散参数(dispersion parameter)。

记:

\[\begin{equation*} \mu=(\mu_1, \mu_2, \dots, \mu_{n})^{\top},\quad X=(x_1, x_2, \dots, x_{n}),\quad y=(y_1, y_2, \dots, y_{n})^{\top} \end{equation*}\]

14.7.1 Logistic模型

Definition 14.31. 称以下模型为逻辑回归模型:

\[\begin{equation*} y_i\mid x_i\sim\operatorname{Bernoulli}(p_i),\quad\operatorname{E}(y_i\mid x_i)=p_i=\operatorname{P}(y_i=1\mid x_i)=\frac{1}{1+\exp(-x_i^{\top}\beta)},\quad i=1,2,\dots,n \end{equation*}\]

其中\(y_i\)相互独立,\(x_i\)为第\(i\)个观测的\(p\times1\)特征向量,\(\beta\)为\(p\times1\)的回归系数向量。记\(p=(p_1, p_2, \dots, p_{n})^{\top},\;X=(x_1^{\top};x_2^{\top};\cdots;x_n^{\top}),\;y=(y_1, y_2, \dots, y_{n})^{\top}\)。

Property 14.7.1. 对于定义 14.31,有如下结论:

  1. 模型的对数似然函数为:

    \[\begin{equation*} \ln L(\beta)=\sum_{i=1}^{n}\left[y_i\log(p_i)+(1-y_i)\log(1-p_i)\right] \end{equation*}\]

  2. 模型的对数似然函数对\(\beta\)的梯度为:

    \[\begin{equation*} \frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta}=X^{\top}(y-p) \end{equation*}\]

  3. 模型的对数似然函数对\(\beta\)的Hesse矩阵为:

    \[\begin{equation*} \frac{\mathop{}\!\mathrm{d}^2\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta^{\top}\mathop{}\!\mathrm{d}\beta}=-X^{\top}\operatorname{diag}\{p_1(1-p_1),p_2(1-p_2),\dots,p_n(1-p_n)\}X \end{equation*}\]

证明. (1)由Bernulli分布的概率函数及性质 6.2.1(5.c)立即可得。

(2)对\(\ell(\beta)\)求导:

\[\begin{equation*} \frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta}=\sum_{i=1}^n\left[\frac{y_i}{p_i}-\frac{1-y_i}{1-p_i}\right]\cdot\frac{\mathop{}\!\mathrm{d}p_i}{\mathop{}\!\mathrm{d}\beta} \end{equation*}\]

而:

\[\begin{equation*} \frac{\mathop{}\!\mathrm{d}p_i}{\mathop{}\!\mathrm{d}\beta}=-[1+\exp(-x_i^{\top}\beta)]^{-2}(-x_i)\exp(-x_i^{\top}\beta)=p_i(1-p_i)x_i \end{equation*}\]

代入上式得:

\[\begin{align*} \frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta}&=\sum_{i=1}^{n}\left[\frac{y_i}{p_i}-\frac{1-y_i}{1-p_i}\right]p_i(1-p_i)x_i=\sum_{i=1}^{n}[y_i(1-p_i)-(1-y_i)p_i]x_i \\ &=\sum_{i=1}^{n}(y_i-y_ip_i-p_i+y_ip_i)x_i=\sum_{i=1}^n(y_i-p_i)x_i=X^{\top}(y-p) \end{align*}\]

(3)对上式再求导:

\[\begin{align*} \frac{\mathop{}\!\mathrm{d}^2\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta^{\top}\mathop{}\!\mathrm{d}\beta} &=-\sum_{i=1}^{n}\frac{\mathop{}\!\mathrm{d}p_i}{\mathop{}\!\mathrm{d}\beta}x_i^{\top}=-\sum_{i=1}^{n}p_i(1-p_i)x_ix_i^{\top} \\ &=-X^{\top}\operatorname{diag}\{p_1(1-p_1),p_2(1-p_2),\dots,p_n(1-p_n)\}X \end{align*}\]

◻

14.7.2 Poisson回归

Definition 14.32. 称以下模型为Poisson回归模型:

\[\begin{equation*} y_i\mid x_i\sim\operatorname{Poisson}(\lambda_i),\quad\operatorname{E}(y_i\mid x_i)=\operatorname{Var}(y_i\mid x_i)=\lambda_i=\exp(x_i^{\top}\beta),\quad i=1,2,\dots,n. \end{equation*}\]

其中\(y_i\in\mathbb{N}\)且相互独立,\(x_i\)为第\(i\)个观测的\(p\times1\)特征向量,\(\beta\)为\(p\times1\)的回归系数向量。记:

\[\begin{equation*} \lambda=(\lambda_1, \lambda_2, \dots, \lambda_{n})^{\top},\quad X=(x_1^{\top};x_2^{\top};\cdots;x_n^{\top}),\quad y=(y_1, y_2, \dots, y_{n})^{\top} \end{equation*}\]

Property 14.7.2. 对于定义 14.32,有如下结论:

  1. 模型的对数似然函数为:

    \[\begin{equation*} \ln L(\beta)=\sum_{i=1}^{n}\left[x_i^T\beta y_i-\ln(y_i!)-\lambda_i\right] \end{equation*}\]

  2. 模型的对数似然函数关于\(\beta\)的梯度为:

    \[\begin{equation*} \frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta}=X^{\top}(y-\lambda) \end{equation*}\]

  3. 模型的对数似然函数关于\(\beta\)的Hesse矩阵为:

    \[\begin{equation*} \frac{\mathop{}\!\mathrm{d}^2\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta^{\top}\mathop{}\!\mathrm{d}\beta}=-X^{\top}\operatorname{diag}(\lambda_1, \lambda_2, \dots, \lambda_{n})X \end{equation*}\]

证明. (1)由Poisson分布的概率函数及性质 6.2.1(5.c)立即可得。

(2)注意到:

\[\begin{equation*} \frac{\mathop{}\!\mathrm{d}(x_i^{\top}\beta)}{\mathop{}\!\mathrm{d}\beta}=x_i,\quad\frac{\mathop{}\!\mathrm{d}\lambda_i}{\mathop{}\!\mathrm{d}\beta}=\frac{\mathop{}\!\mathrm{d}\exp(x_i^{\top}\beta)}{\mathop{}\!\mathrm{d}\beta}=\exp(x_i^{\top}\beta)x_i=\lambda_ix_i \end{equation*}\]

所以:

\[\begin{align*} \frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta}=\sum_{i=1}^{n}\left(y_ix_i-\lambda_ix_i\right)=\sum_{i=1}^{n}x_i(y_i-\lambda_i)=X^{\top}(y-\lambda) \end{align*}\]

(3)对上式再求导:

\[\begin{equation*} \frac{\mathop{}\!\mathrm{d}^2\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta^{\top}\mathop{}\!\mathrm{d}\beta}=-\sum_{i=1}^{n}\lambda_ix_ix_i^{\top}=-X^{\top}\operatorname{diag}(\lambda_1, \lambda_2, \dots, \lambda_{n})X \end{equation*}\]

◻

14.7.3 统一理论

如果我们使用Newton法进行极大似然估计的求解,根据性质 14.7.1(2)(3)和性质 14.7.2(2)(3),可以发现最后的迭代问题变成了求解下述线性方程组的问题:

\[\begin{equation*} X^{\top}WXz=X^{\top}(y-\mu) \end{equation*}\]

这其实正是定义 14.14下的正则方程。这类问题的一个重要优点在于,极大似然估计最终可以转化为带权残差意义下的最小化问题,从而在形式上延续了最小二乘法通过最小化残差确定参数的直观思想。

能不能将这类推广的线性模型统一起来,用一个统一的公式去表达?如果可以的话,能不能尽量扩大这个统一形式的表达范围,使得囊括尽可能多的情况?我们需要来分析产生上述线性方程组的原因。

首先分析\(\ln L(\beta)\)关于\(\beta\)的梯度。\(\beta\)是通过预测均值引入模型的,要求关于\(\beta\)的梯度必然需要引入均值进行链式法则计算,而模型与均值的关系一般为均值与模型参数有一个函数关系,于是我们设定模型的参数为\(\theta\),这里的\(\theta\)未必是模型原始的参数,而可能是原始参数的一个函数。由性质 4.1.1(6)可得:

\[\begin{align*} &\frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\beta}=\left(\frac{\mathop{}\!\mathrm{d}\eta}{\mathop{}\!\mathrm{d}\beta}\right)^{\top}\frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\eta}=\left(\frac{\mathop{}\!\mathrm{d}\eta}{\mathop{}\!\mathrm{d}\beta}\right)^{\top}\left(\frac{\mathop{}\!\mathrm{d}\mu}{\mathop{}\!\mathrm{d}\eta}\right)^{\top}\frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\mu} \\ =&\left(\frac{\mathop{}\!\mathrm{d}\eta}{\mathop{}\!\mathrm{d}\beta}\right)^{\top}\left(\frac{\mathop{}\!\mathrm{d}\mu}{\mathop{}\!\mathrm{d}\eta}\right)^{\top}\left(\frac{\mathop{}\!\mathrm{d}\theta}{\mathop{}\!\mathrm{d}\mu}\right)^{\top}\frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\theta}=X^{\top}\frac{\mathop{}\!\mathrm{d}\mu}{\mathop{}\!\mathrm{d}\eta}\frac{\mathop{}\!\mathrm{d}\theta}{\mathop{}\!\mathrm{d}\mu}\frac{\mathop{}\!\mathrm{d}\ln L(\beta)}{\mathop{}\!\mathrm{d}\theta} \end{align*}\]

因为上式中间两项导数仅分别和链接函数与模型均值相关,和\(y\)无关,所以最后一项必然要出现\(y\),这使得\(\ln L(\beta)\)中必然出现\(y\theta\)这一项。


  1. 注意区分广义最小二乘估计,两者的模型命名都是广义线性模型。↩︎

COMPUTATIONAL NOTES

计算实验

实验01

线性回归

R · Quarto

本实验回答怎样完成一次普通多元线性回归分析,重点是回归方程显著性、各变量显著性、\(R^2\)、残差诊断、Cook距离和Box-Cox变换。

MASS::cpus记录了209台计算机的硬件参数与相对性能。以实际性能perf为响应变量,使用机器周期syct、最小内存mmin、最大内存mmax、缓存cach、最小通道数chmin和最大通道数chmax作为自变量。estperf是数据中已有的性能估计,若把它作为自变量会把目标信息重新送入模型,因此不使用。

考虑模型

\[ \operatorname{perf}_i =\beta_0+\beta_1\operatorname{syct}_i +\beta_2\operatorname{mmin}_i +\beta_3\operatorname{mmax}_i +\beta_4\operatorname{cach}_i +\beta_5\operatorname{chmin}_i +\beta_6\operatorname{chmax}_i+\varepsilon_i \]

数据概况

先确认样本量、变量含义、缺失情况和基本取值。

cpu <- MASS::cpus
cpu_predictors <- c("syct", "mmin", "mmax", "cach", "chmin", "chmax")
cpu_model_data <- cpu[c(cpu_predictors, "perf")]

dim(cpu_model_data)
[1] 209   7
summary(cpu_model_data)
      syct           mmin            mmax            cach           chmin          chmax      
 Min.   :  17   Min.   :   64   Min.   :   64   Min.   :  0.0   Min.   : 0.0   Min.   :  0.0  
 1st Qu.:  50   1st Qu.:  768   1st Qu.: 4000   1st Qu.:  0.0   1st Qu.: 1.0   1st Qu.:  5.0  
 Median : 110   Median : 2000   Median : 8000   Median :  8.0   Median : 2.0   Median :  8.0  
 Mean   : 204   Mean   : 2868   Mean   :11796   Mean   : 25.2   Mean   : 4.7   Mean   : 18.3  
 3rd Qu.: 225   3rd Qu.: 4000   3rd Qu.:16000   3rd Qu.: 32.0   3rd Qu.: 6.0   3rd Qu.: 24.0  
 Max.   :1500   Max.   :32000   Max.   :64000   Max.   :256.0   Max.   :52.0   Max.   :176.0  
      perf     
 Min.   :   6  
 1st Qu.:  27  
 Median :  50  
 Mean   : 106  
 3rd Qu.: 113  
 Max.   :1150  
sum(!complete.cases(cpu_model_data))
[1] 0

对数据进行标准化。

cpu_standardized_predictors <- as.data.frame(
  scale(cpu_model_data[cpu_predictors])
)
cpu_standardized_data <- cbind(
  perf = cpu_model_data$perf,
  cpu_standardized_predictors
)

计算条件数。

#|
cpu_condition_number <- kappa(
  as.matrix(cpu_standardized_predictors),
  exact = TRUE
)

cat(
  sprintf(
    "\nCondition number of the standardized CPU design matrix: %.4f\n",
    cpu_condition_number
  )
)

Condition number of the standardized CPU design matrix: 4.3932

条件数未超过10,无需额外处理。

拟合与显著性

拟合全模型并查看结果。

cpu_ols <- lm(perf ~ ., data = cpu_standardized_data)
summary(cpu_ols)

Call:
lm(formula = perf ~ ., data = cpu_standardized_data)

Residuals:
   Min     1Q Median     3Q    Max 
-195.8  -25.2    5.4   26.5  385.7 

Coefficients:
            Estimate Std. Error t value Pr(>|t|)    
(Intercept)   105.62       4.15   25.45  < 2e-16 ***
syct           12.72       4.56    2.79   0.0058 ** 
mmin           59.32       7.09    8.37  9.4e-15 ***
mmax           65.33       7.53    8.68  1.3e-15 ***
cach           26.05       5.67    4.59  7.6e-06 ***
chmin          -1.84       5.83   -0.32   0.7526    
chmax          38.55       5.72    6.74  1.6e-10 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 60 on 202 degrees of freedom
Multiple R-squared:  0.865, Adjusted R-squared:  0.861 
F-statistic:  215 on 6 and 202 DF,  p-value: <2e-16

残差与强影响观测

诊断只保留三幅最常用的图:残差与拟合值图、正态Q–Q图和Cook距离图。第一幅图检查残差是否大致分布在\(0\)附近、残差方差是否大致稳定(残差分布宽度与拟合值之间无系统性关系);第二幅图检查残差是否近似符合正态分布;第三幅图检查哪些观测会明显影响拟合结果。

plot_regression_diagnostics <- function(model) {
  old_par <- par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
  plot(model, which = 1, id.n = 3)
  plot(model, which = 2, id.n = 3)
  plot(model, which = 4, id.n = 3)
  par(old_par)
}

plot_regression_diagnostics(cpu_ols)

实验 01「线性回归」结果 1(图 1)

从残差—拟合值图看,残差并没有随机地围绕零水平线分布,而是呈现明显的弯曲趋势:在较小拟合值处残差偏正,中等拟合值处偏负,随后又逐渐上升;同时,随着拟合值增大,残差的波动范围明显扩大,存在异方差现象。Q–Q 图中部虽然大致贴近参考直线,但两端,尤其是右尾,出现严重偏离,表明残差分布具有重尾或右偏特征,并不满足正态性假设。

从 Cook 距离图看,大多数观测的 Cook 距离接近于零,对回归结果的影响较小,但第 200 个观测的 Cook 距离接近 3,远高于常用警戒值 1,说明它是一个极强的影响点,可能显著改变回归系数、拟合曲线及推断结论;第 10 个观测的 Cook 距离也接近 1,同样需要重点检查,第 199 个观测以及少数其他观测也表现出一定影响力。结合前面的残差图,第 200 个观测同时具有较大的残差,因此其异常性尤其值得关注。不过,Cook 距离较大并不意味着应直接删除该观测,而应首先检查是否存在测量异常或特殊的数据生成机制,并分别在保留和剔除这些观测的情况下重新拟合模型,比较回归系数、显著性和预测结果是否发生明显变化。

Box-Cox变换

perf的观测全部为正,可以考虑

\[ y_i^{(\lambda)}= \begin{cases} \dfrac{y_i^\lambda-1}{\lambda},&\lambda\ne0,\\[6pt] \log y_i,&\lambda=0. \end{cases} \]

MASS::boxcox通过轮廓似然选择\(\lambda\)。最大点给出\(\hat{\lambda}\),水平虚线 对应近似95%置信区间。

cpu_boxcox_profile <- MASS::boxcox(
  cpu_ols,
  lambda = seq(-1, 1, by = 0.01),
  plotit = TRUE
)

cpu_lambda <- cpu_boxcox_profile$x[
  which.max(cpu_boxcox_profile$y)
]
cpu_loglik_cutoff <- max(cpu_boxcox_profile$y) -
  qchisq(0.95, df = 1) / 2
cpu_lambda_interval <- range(
  cpu_boxcox_profile$x[
    cpu_boxcox_profile$y >= cpu_loglik_cutoff
  ]
)

abline(h = cpu_loglik_cutoff, lty = 2, col = colour_smooth)
abline(v = cpu_lambda, lty = 2, col = colour_main)

实验 01「线性回归」结果 1(图 2)

c(
  LambdaEstimate = cpu_lambda,
  Lower = cpu_lambda_interval[1],
  Upper = cpu_lambda_interval[2]
)
LambdaEstimate          Lower          Upper 
          0.29           0.21           0.37 

按\(\hat{\lambda}\)变换响应变量后重新拟合。需要重新检查总体显著性、各变量显著性和 残差图;原尺度与变换尺度的\(R^2\)解释的是不同响应,不能直接比较大小。

box_cox_transform <- function(y, lambda) {
  if (abs(lambda) < 1e-8) {
    log(y)
  } else {
    (y^lambda - 1) / lambda
  }
}

cpu_boxcox_data <- cpu[cpu_predictors]
cpu_boxcox_data$perf.bc <- box_cox_transform(
  cpu$perf,
  cpu_lambda
)
cpu_boxcox_data <- cpu_boxcox_data[c("perf.bc", cpu_predictors)]

cpu_boxcox_model <- lm(perf.bc ~ ., data = cpu_boxcox_data)
summary(cpu_boxcox_model)

Call:
lm(formula = perf.bc ~ ., data = cpu_boxcox_data)

Residuals:
   Min     1Q Median     3Q    Max 
-3.981 -0.891 -0.016  0.735  5.738 

Coefficients:
              Estimate Std. Error t value Pr(>|t|)    
(Intercept)  5.1953204  0.1821762   28.52  < 2e-16 ***
syct        -0.0016722  0.0003967   -4.22  3.8e-05 ***
mmin         0.0001834  0.0000414    4.43  1.5e-05 ***
mmax         0.0001585  0.0000145   10.90  < 2e-16 ***
cach         0.0275607  0.0031603    8.72  1.0e-15 ***
chmin        0.0273811  0.0193763    1.41     0.16    
chmax        0.0081228  0.0049827    1.63     0.10    
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.36 on 202 degrees of freedom
Multiple R-squared:  0.882, Adjusted R-squared:  0.878 
F-statistic:  251 on 6 and 202 DF,  p-value: <2e-16
plot_regression_diagnostics(cpu_boxcox_model)

实验 01「线性回归」结果 1(图 3)

可以发现经过变换后模型的异方差性与非正态性得到了很好的治理。

实验02

复共线性与岭回归

R · Quarto

longley是展示复共线性的经典数据。这里不先计算相关系数或VIF,而是先像普通回归一样拟合模型,从结果本身发现问题。

先拟合普通最小二乘模型

以就业人数Employed为响应变量,其余6个变量全部进入模型。对原始数据做标准化后再拟合模型。

longley_data <- datasets::longley
longley_predictors <- c(
  "GNP.deflator",
  "GNP",
  "Unemployed",
  "Armed.Forces",
  "Population",
  "Year"
)
longley_standardized_predictors <- as.data.frame(
  scale(longley_data[longley_predictors])
)
longley_data <- cbind(
  Employed = longley_data$Employed,
  longley_standardized_predictors
)
longley_ols <- lm(Employed ~ ., data = longley_data)
summary(longley_ols)

Call:
lm(formula = Employed ~ ., data = longley_data)

Residuals:
     Min       1Q   Median       3Q      Max 
-0.41011 -0.15767 -0.02816  0.10155  0.45539 

Coefficients:
             Estimate Std. Error t value Pr(>|t|)    
(Intercept)  65.31700    0.07621 857.026  < 2e-16 ***
GNP.deflator  0.16254    0.91636   0.177 0.863141    
GNP          -3.56025    3.32884  -1.070 0.312681    
Unemployed   -1.88783    0.45639  -4.136 0.002535 ** 
Armed.Forces -0.71904    0.14912  -4.822 0.000944 ***
Population   -0.35549    1.57259  -0.226 0.826212    
Year          8.70850    2.16851   4.016 0.003037 ** 
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.3049 on 9 degrees of freedom
Multiple R-squared:  0.9955,    Adjusted R-squared:  0.9925 
F-statistic: 330.3 on 6 and 9 DF,  p-value: 4.984e-10

这个输出出现了值得追问的现象:系数表显示若干估计的标准误相对于系数本身很大。

“整体显著且\(R^2\)很高,单个系数却不稳定”是复共线性的典型信号。多个自变量可能共同解释了就业人数,却很难把这部分解释力稳定地分配给某一个系数。此时有必要返回自变量本身,检查它们是否包含大量重复信息。

相关性热图与VIF

longley_x <- longley_data[
  setdiff(names(longley_data), "Employed")
]
colour_main <- "#355c8a"
colour_smooth <- "#c45a3c"

plot_correlation_heatmap <- function(correlation, title) {
  distance <- as.dist(1 - abs(correlation))
  variable_order <- hclust(distance)$order
  ordered_correlation <- correlation[
    variable_order,
    variable_order,
    drop = FALSE
  ]
  displayed_correlation <- ordered_correlation[
    nrow(ordered_correlation):1,
    ,
    drop = FALSE
  ]
  palette <- colorRampPalette(
    c("#b2182b", "#f7f7f7", "#2166ac")
  )(201)

  old_par <- par(mar = c(7, 7, 3, 1))
  image(
    x = seq_len(ncol(displayed_correlation)),
    y = seq_len(nrow(displayed_correlation)),
    z = t(displayed_correlation),
    col = palette,
    zlim = c(-1, 1),
    axes = FALSE,
    xlab = "",
    ylab = "",
    main = title,
    asp = 1
  )
  axis(
    1,
    at = seq_len(ncol(displayed_correlation)),
    labels = colnames(displayed_correlation),
    las = 2,
    tick = FALSE
  )
  axis(
    2,
    at = seq_len(nrow(displayed_correlation)),
    labels = rownames(displayed_correlation),
    las = 2,
    tick = FALSE
  )

  for (row in seq_len(nrow(displayed_correlation))) {
    for (column in seq_len(ncol(displayed_correlation))) {
      value <- displayed_correlation[row, column]
      text(
        column,
        row,
        labels = sprintf("%.2f", value),
        col = ifelse(abs(value) >= 0.55, "white", "grey15"),
        cex = 0.78,
        font = ifelse(row + column == nrow(displayed_correlation) + 1, 2, 1)
      )
    }
  }

  box()
  par(old_par)
}

longley_correlation <- cor(longley_x)

plot_correlation_heatmap(
  longley_correlation,
  "Longley Predictors: Correlation Heatmap"
)

实验 02「复共线性与岭回归」结果 1(图 1)

从图中可以发现Year、GNP、Population和GNP.deflator之间存在强相关关系。再计算VIF值与条件数:

longley_x_matrix <- as.matrix(longley_x)
calculate_vif <- function(x) {
  result <- vapply(
    seq_len(ncol(x)),
    function(j) {
      auxiliary_model <- lm(x[, j] ~ x[, -j, drop = FALSE])
      1 / (1 - summary(auxiliary_model)$r.squared)
    },
    numeric(1)
  )

  names(result) <- colnames(x)
  result
}

longley_vif <- calculate_vif(longley_x_matrix)
longley_eigenvalues <- eigen(
  longley_correlation,
  symmetric = TRUE,
  only.values = TRUE
)$values
longley_condition_indices <- max(longley_eigenvalues) / min(longley_eigenvalues)

sort(longley_vif, decreasing = TRUE)
         GNP         Year   Population GNP.deflator   Unemployed Armed.Forces 
  1788.51348    758.98060    399.15102    135.53244     33.61889      3.58893 
longley_condition_indices
[1] 12220.01

由输出可见,多个VIF远大于常用警示值,条件数也很高。这解释了前面系数标准误较大、显著性结论不稳定的原因。删除变量并不是唯一选择:若变量具有明确含义而分析目标主要是预测,可以保留它们并使用岭回归。

岭回归

下面使用MASS::lm.ridge计算岭迹。

if (!requireNamespace("MASS", quietly = TRUE)) {
  stop("This document requires the MASS package.")
}

lambda_grid <- seq(0, 0.2, by = 0.0005)
longley_ridge_path <- MASS::lm.ridge(
  Employed ~ .,
  data = longley_data,
  lambda = lambda_grid
)

plot(longley_ridge_path)

实验 02「复共线性与岭回归」结果 1(图 2)

岭迹展示了系数随\(\lambda\)增加逐渐收缩并趋于稳定的过程。从岭际图上看,我们可以选择0.1作为惩罚强度。